结构化数据标注:别把它当打标签,它决定机器能不能读懂你
2026-11-20 18:52:14 分类:GEO优化
说实话,很多人头一回听到“结构化数据标注”,脑子里蹦出来的画面是——一群人对着图片画框、给文字贴标签。
不完全是。
画框那是感知层的事。结构化数据标注干的是另一件活儿:把“人一看就懂、机器一脸懵”的信息,翻译成一套机器能直接读取的字段和值。它更像填表格,不是阅读理解。
先弄清楚:这东西通常用在哪儿
举个生活化的例子。你开一家小馆子,网页上写着“人均80,营业到凌晨两点,周一休息”。这句话人看得懂。可搜索引擎抓过去,它不确定“80”指的是人均,还是点单起步价;也不确定“周一休息”是不是常年有效。
把它标注成结构化数据——用 Schema.org 里的 Restaurant 类型,priceRange 填上价格区间,openingHoursSpecification 把一周七天的时段拆开写——机器立刻就能比对、筛选,甚至直接拿去生成答案。
 本地商家网页Schema结构化数据标注代码示例
从实操角度看,结构化数据标注主要落在三类场景:网页端的 Schema 标记、知识图谱里的实体与关系标注,以及喂给模型做微调的训练语料标注。三者的活儿长得挺像,目的差得挺远。
网页标注,是为了让搜索引擎和 AI 摘要工具抓得准。
知识图谱标注,是为了让实体之间连上线。
语料标注,是为了让模型学会某种输出格式,或者某种判断标准。
几个容易踩的坑,说慢一点
别自己造词。 这是新手翻车频率偏高的一处。Schema.org 有现成的词汇表,你非要用自定义字段名,搜索引擎通常就选择忽略。据一些用户反馈,改回标准词汇之后,页面被引用的情况确实有变化——当然这个因人而异,跟站点本身的权重也有关。
粒度别太细,也别太粗。 标得过细,维护成本上去了,字段一多就容易前后打架;标得过粗,约等于没标。我的做法是先锁定对你业务真正关键的 5 到 8 个字段,跑通了再往外扩。
一致性比覆盖率要紧。 十个人标同一批数据,三个人把“成立年份”写成 2015,两个人写成“2015年”——机器读到的是两种东西。所以标注规范文档得写,抽检机制也得有。这个环节偷懒,后面清洗数据的时间会成倍还回来。
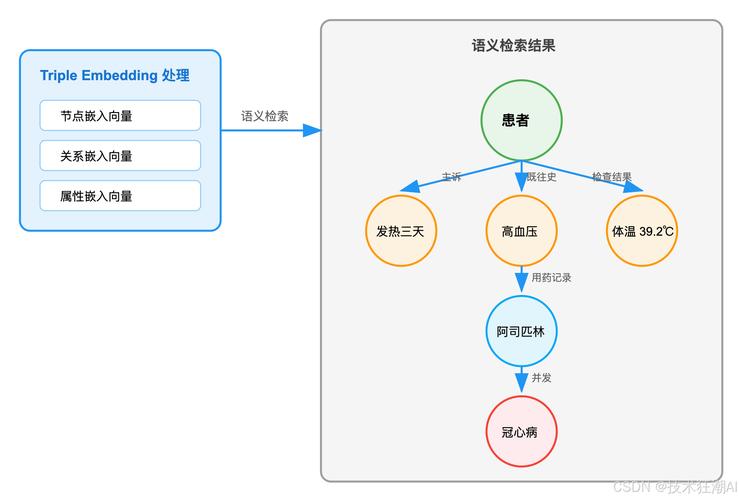 知识图谱实体关系三元组标注界面示意图
时间字段尤其要小心。 时区、格式、是否包含结束日期……这些细节在人看来无所谓,在机器看来就是能不能匹配上的问题。
它和“训练数据标注”是一回事吗
 它和“训练数据标注”是一回事吗
不是。
结构化数据标注的重点在“结构”,把信息塞进预定义的槽位里。而常见的训练数据标注,重点在“判断”——这句话是正面还是负面,这个回答有没有害处。
有意思的是,这两年两者的边界在变模糊。大模型开始直接消费结构化数据;同时结构化数据的生成,也在借助模型做预标注、人工做校验。人工从“从头标”变成“审和改”,效率是上去了,但对规范的依赖反而更强——因为模型错起来,是一整批一起错。
再说个常被问到的:标注完就一劳永逸了吗?
基本不是。营业时间会变,价格会调,产品下架、地址搬迁,结构化数据跟着过期。一般建议把标注字段和内容管理系统挂上钩,能自动同步的尽量别靠人手改。
那人工还留着干嘛?留着处理那些没法自动化的判断——比如一个实体到底该归到哪个类别,两个名称是不是同一个东西。
这类模糊地带,机器目前还是容易犯迷糊。
您在实际做结构化数据标注的时候,还遇到过哪些让人头疼的情况?欢迎结合具体场景继续聊。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:结构化数据标注:别把它当打标签,它决定机器能不能读懂你
文章链接:https://www.ttrenwu.com/geo/4259.html
