模型不是故意骗你。它只是在接龙。给定前文,猜下一个词。猜得顺,不等于猜得对。
比如问“某小城图书馆几点关门”,它可能编一个“晚上九点”。语气笃定,格式工整。你打电话一问,人家六点就锁门了。据一些用户反馈,这种“格式正确但事实错位”的回答,在客服、医疗摘要、法律检索里出现时更麻烦。
反幻觉技术基础,说白了就是让模型少猜、多查、会认怂。
基础招式一:检索增强,把闭卷考试改成开卷
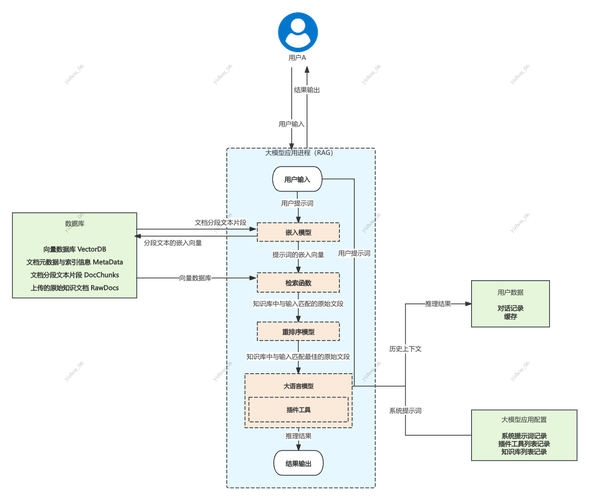
检索增强生成(RAG)是常见思路。用户提问后,系统先去知识库、网页、数据库里找相关段落。然后把这些材料塞进提示词,让模型基于材料回答。
这样做的好处:有出处可查。坏处:检索错了,模型会跟着错。所以基础环节包括文档切分、向量检索、关键词混合、重排序。
举个例子,公司内部问“年假怎么算”,如果检索到三年前的旧制度,模型可能给出过期答案。需要加时间过滤和权限过滤。
从实操角度看,RAG 不是万能药,它更像给模型递了一本参考书。书选错了,答案照样跑偏。
基础招式二:解码约束与置信度,让模型学会“我不确定”

模型生成时,有几个旋钮。温度、top-p、重复惩罚。温度调低,回答更保守,但可能死板。调高,创意多,幻觉也多。反幻觉场景通常把温度压低。
另外,可以要求模型输出引用编号。没有引用,就不让结论落地。
有些系统会做置信度校准:模型说“高置信”,但实际可能错。需要外部校验器,比如规则引擎、知识图谱、搜索 API。
工具调用很关键。问“今天汇率多少”,与其让模型背,不如让它调用接口。查完再总结。这样错误率会下来。但接口挂了怎么办?要有降级话术。别硬答。
基础招式三:后验校验,把“我觉得”变成“我查过”
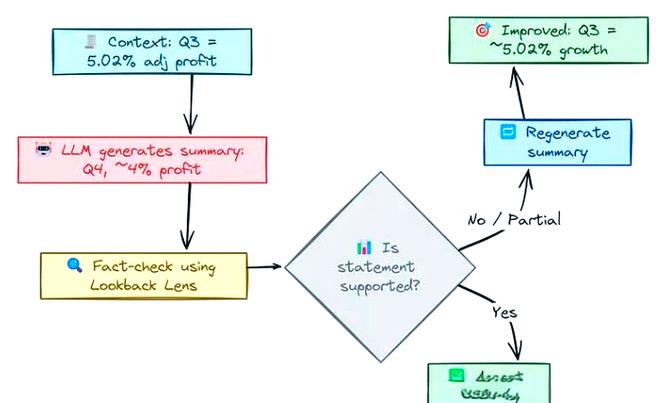
回答生成完,不等于结束。后验校验会拿回答里的实体、数字、时间、关系,去外部源比对。
比如“某公司 2023 年营收 120 亿”。系统抽出来,搜公告,发现是 102 亿。那就标记冲突,触发重写或人工审核。
人工反馈也重要。标注哪些是幻觉,回灌到评测集。下次微调或提示优化时用。注意,人工审核成本高。适合高风险场景,比如医疗、金融、工业安全。低风险闲聊,不必上全套。对吧?

常见误区和落地注意
有人以为加一句“不要幻觉”就能解决。说实话,作用有限。提示词能降低概率,不能消除。
还有人只靠一个大模型自查。模型自查有时会护短。可以换一个模型做裁判,或者用规则校验。
另一个误区:追求零错误。现实里,反幻觉是降低风险,不是消灭风险。需要设置兜底:敏感问题转人工,答案附来源,允许用户反馈。
维护周期上,知识库要更新。行业普遍观察,过期数据是幻觉的重要来源。别忽略。
你遇到的反幻觉问题,是检索不到,还是模型不认错?欢迎结合具体场景继续聊。
