你搜“苹果”,返回一屏 iPhone。你要的是水果。翻了三页才看见果树的照片。
这事儿怪谁?怪字面匹配。它只认词对不对得上,不管你脑子里想的是什么。
语义检索其实在算“意思”之间的距离
做法不玄。把一段文本压成一串数字,也就是向量。意思接近的句子,向量在高维空间里挨得近。你说“手机发烫”,文档里写“设备温度偏高”,字面几乎不重合,两串向量却可能几乎贴在一起。
这就是语义检索与匹配的核心逻辑:不比字,比意思。
据一些用户反馈,这类检索在模糊提问上挺讨喜。你不必猜中关键词,用大白话说就行。刚上手的人容易有惊喜感——原来它真听得懂人话。
但别急着高兴。向量也不是万能钥匙。文本要“翻译”成数字,翻译过程有损耗。翻得准不准,看模型认不认得你这个领域。拿通用模型去处理法律条文、医学病历,结果往往让人挠头。

匹配效果差,八成是这几个环节在拖后腿
从实操角度看,很多人一上手就想着换更大的模型。其实不一定是问题的根子。下面这几处更值得先查。
分块策略。文档切得太碎,一句话被劈成两半,语义就散了。切得太大,一个向量里塞了五个话题,检索时谁都不像。常见做法是按段落切,再留一点重叠区,比如前后各留一句话。
召回方式。纯向量召回有短板。人名、型号、编号、订单号这类精确词,向量容易糊成一团。稳妥些是混合检索:一路走关键词负责精确命中,一路走向量负责兜住同义改写。两路结果合起来再排一次序,这一步通常叫重排,往往能把真正有用的结果往上顶几名。
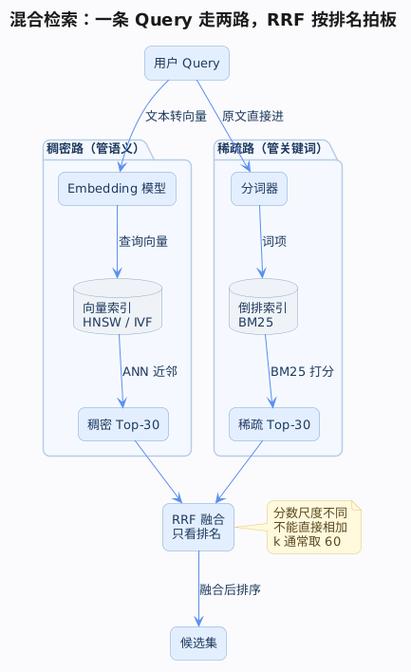
查询本身的质量。这条最容易被忽略。用户输入常常很脏。“那个怎么弄一下”“上次说的那个东西”,这种句子直接投进去,向量也没辙。加一层查询改写,把口语句补成完整问句,命中率会明显不一样。
几个常被问到的问题

中文分词要不要做?看模型。多数现代向量模型按子词处理,不太依赖分词器。但你的库里要是塞满行业黑话,加个自定义词典还是有用的。
相似度用什么算?余弦相似度比较常见,也有人用内积。原则很简单:模型训练时用什么,检索时就跟着用什么,别自己乱配,不然分数看着正常,排序却莫名其妙。
多语言场景怎么办?挑多语言对齐的模型。不然中文问、英文答,向量对不上号,匹配直接垮掉。
要不要微调?如果你的语料高度垂直,比如全是内部工单、专业术语,微调一轮的收益可能比换模型大。不过代价是要标数据,这个可能因人而异。
还有个我自己踩过的坑:评测别只看前三条。要看召回率,看漏掉的那些。真实用户往往翻到第五、第六条才找到想要的。
您在搭建或使用这类系统时,还遇到过哪些离谱的匹配结果?欢迎带上具体场景接着聊。
