搜“苹果充电线”,结果给你推了一箱红富士。
这事你多半遇到过。早年的关键词检索就这样——它只认字面。逐字比对,谁跟你那几个字重合得多,谁排前面。“苹果”对上了“苹果”,剩下的事它一概不管。
从“对字”到“对意思”,中间隔着一层向量
语义检索与匹配,说白了就是让机器别光看字,去看意思。
怎么做到的?通常是把一段文本——不管是用户那句随口写的“手机快没电了想找根线冲一下”,还是商品标题——丢进一个模型,压成一串数字。这串数字有名字,叫向量。几百维到几千维,密密麻麻的小数。
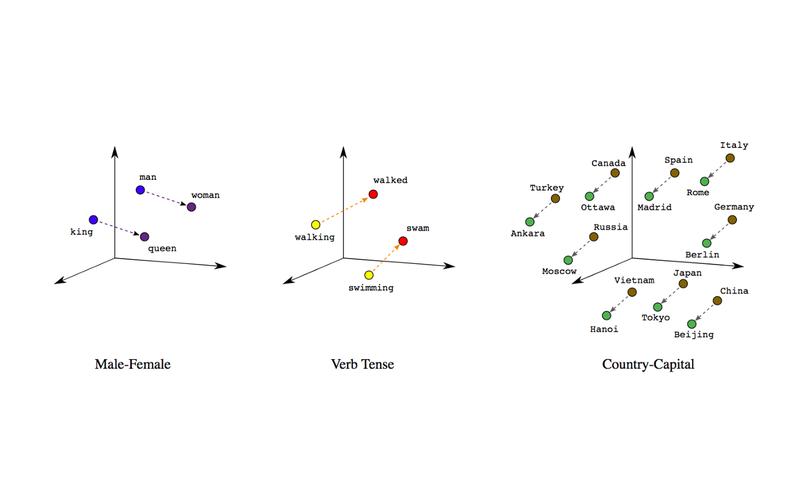
关键在这儿:意思相近的两句话,压出来的点在空间里挨得近;意思差得远的,就离得远。
于是检索变成了算距离。余弦相似度、内积、欧氏距离……名字听着唬人,本质就是量一量两个点靠得有多拢。
有意思的是,模型其实并不知道“充电线”和“数据线”是同义词。它只是从海量语料里发现,这两词老出现在差不多的上下文里。位置像,那就拉近点。
真正难的不是算距离,是把人话对齐
理论挺干净,工程很脏。
从实操角度看,翻车的地方往往集中在这几处:
- 短 query 信息太少。“那个蓝色的”——你让模型去匹配什么?这时候得靠上下文补,或者接一层改写。用户历史、会话上文、近期热词,都是补丁。
- 长尾和错别字。用户打成“充电先”,词表里压根没这词。老办法算编辑距离,现在多是直接把噪声丢给向量模型,指望它扛住。扛不扛得住,说实话看模型。
- 负样本采样。训练时光喂正样本,模型学不出边界。得给“看着像但不对”的例子。比如“苹果手机壳”和“苹果醋”,字面很像,语义完全是两码事。
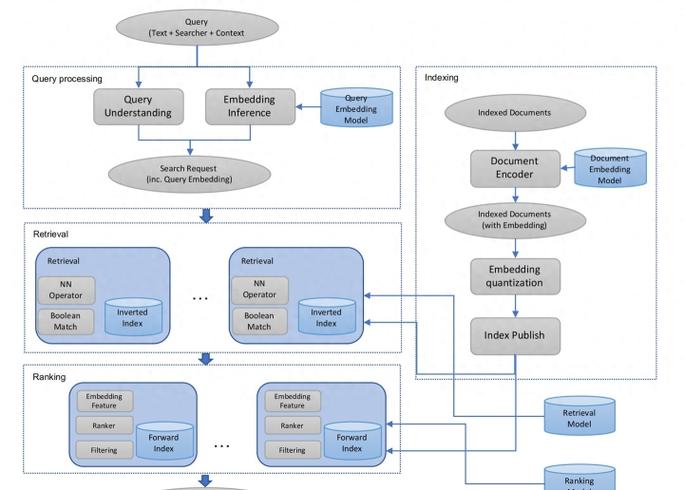
还有一点常被忽略:语义匹配通常要和字面匹配混着用。
为什么?因为有些查询,用户要的就是精确。搜型号“SM-S9280”,你非要语义泛化到“三星旗舰手机”,他反而要骂人。行业里较常见的做法是双路召回,一路 BM25 走字面,一路向量走语义,再统一融合排序。
据一些做搜索的同行反馈,融合权重调起来比模型本身还费劲。权重偏语义,精确查询就变糊;偏向字面,长尾又召不回来。
和关键词匹配、推荐系统到底差在哪

这三个东西经常被混为一谈。
关键词匹配认字符串。你写“笔记本”,它就找含“笔记本”的页面,哪怕那页在讲纸质本子还是散热底座——它分不清。
语义检索与匹配认意思。它知道“番茄”和“西红柿”是一回事,也知道“苹果发布会”和“苹果派”不是。
推荐系统看的则不是你这句 query,而是你这个人。同一个人搜同一个词,这周和上周推的东西可以完全不同。两者底层都用向量,但目标函数不一样。一个解决“匹配”,一个解决“猜你想要”。
这三条边界,在真实系统里其实是糊的。现在的搜索页,检索结果和“猜你喜欢”常常并排躺着。
选型之前,我会先问自己几个问题
如果你正准备接一套语义检索,别急着挑模型。先问:
数据量多大?几万条和几亿条是两回事。前者一个向量库加暴力检索就够;后者得上近似最近邻索引,还得权衡召回率和延迟。
延迟能容忍多少?在线搜索常卡在几十毫秒。把 query 编码成向量这一步,就够吃掉不少预算。
有没有标注数据?没有的话,要么拿通用模型先跑起来,要么从点击日志里挖弱监督信号。这个可能因人而异,得看业务有没有流量底子。
需要留意的是,向量模型不是上线一次就完事。语料在变,用户的表达也在变,隔段时间得重新评估。有人把它当静态组件,半年后效果悄悄掉了都不知道为什么。
嗯……扯远了点。回到开头那句。
搜“苹果充电线”蹦出水果,问题不在模型笨,在于我们没告诉它“线”和“果”哪个才是重点。语义检索与匹配干的活,说到底就是替我们把这份上下文补上。补得好不好,还得看数据喂得够不够细。
您在实际检索场景里还踩过哪些坑?欢迎结合具体业务继续聊。
