快讯

生成式AI搜索原理:从关键词匹配到答案生成,中间发生了什么

别把生成式AI搜索当成“更聪明的关键词框”

传统搜索像什么?你输入几个词,它返回一排链接。生成式AI搜索不太一样。它更像先猜你想干嘛,再去翻资料,然后把几段话揉成答案。举个例子。搜“宝宝夜里发烧怎么办”,传统结果给你一堆网页;生成式搜索可能直接说:先量体温,看精神状态,注意补水,出现这些情况去医院。底下还会列参考来源。差别在哪?生成之前有一串检索动作。大模型不是凭空知道这些。
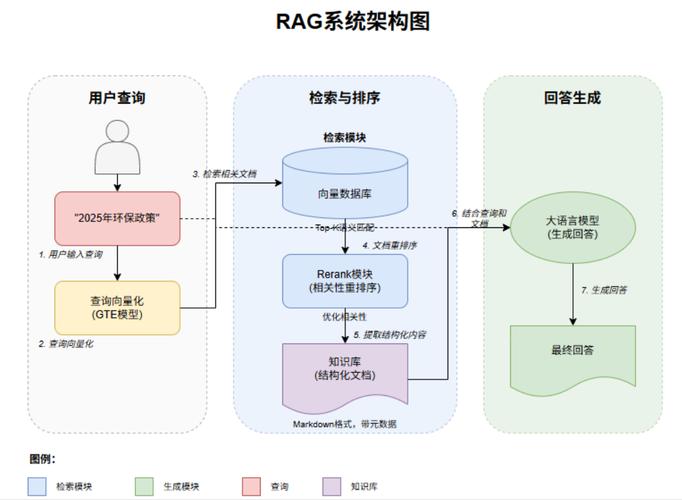
生成式AI搜索原理_RAG检索增强生成架构图

它背后常见的五步流水线

它背后常见的五步流水线
它背后常见的五步流水线
先做查询理解。你打错字、说得含糊,它可能改写、扩展、拆成子问题。比如“北京适合带爸妈去的公园 不累”,会被拆成:北京、公园、无障碍、步行少、适合老人。 接着是召回。系统通常同时跑关键词检索和向量检索。关键词负责精确命中,比如专有名词。向量负责语义相近,比如“不累”可能匹配“平缓路线”“轮椅友好”。 然后是重排。召回一堆候选后,用交叉编码器或重排模型打分。这里决定哪些片段真正相关。说实话,这一步很影响答案质量。 再拼接上下文。把筛选后的片段塞进提示词,大模型根据这些材料组织语言。 接着生成与引用。模型输出答案,同时给出引用编号或来源链接。注意,引用有时不完整,甚至张冠李戴,需要交叉验证。

为什么它有时答得挺像,有时又胡说?

生成式搜索的“知识”来自检索到的材料。材料缺失、过期、矛盾,答案就可能歪。大模型还会补全语言,这既是能力也是风险。比如问“某公司去年营收”,如果检索片段只提到前三季度,它可能顺着写成全年,语气还挺肯定。有点烦。 另外,多跳问题更容易出问题。比如“哪家公司的创始人和某导演是校友,且总部在杭州”。系统要串联多个实体,中间任何一跳错了,后面全歪。 从实操角度看,用户最好把生成式AI搜索当作“研究助理”,不是“裁判”。关键数字、法律条款、医疗建议,回到原始来源核对。
生成式AI搜索原理_大模型答案生成与引用来源流程图

做内容的人,该怎么适应这套原理?

做内容的人,该怎么适应这套原理?
做内容的人,该怎么适应这套原理?
别只堆关键词。生成式搜索更看语义匹配和片段可用性。通常可以这样做: – 把结论写清楚,别绕。 – 关键事实带出处、日期、适用范围。 – 用问答、小标题、列表,方便系统切片。 – 同一主题下,把相关概念说透,别让机器猜。 – 更新旧文,特别是价格、政策、产品功能。 不过话说回来,不同AI搜索产品的检索策略不一样。有的偏重网页索引,有的偏重站内知识,有的接第三方数据库。这个可能因人而异。 据一些用户反馈,带表格、步骤、对比的内容更容易被引用。但别为了被引用硬塞结构,读起来难受,人也不买账。

跟传统SEO有啥不一样?

跟传统SEO有啥不一样?
跟传统SEO有啥不一样?
传统SEO常盯排名、点击、关键词密度。生成式搜索里,内容可能被拆成片段,作为答案的一部分出现。曝光不等于点击。品牌要想的是:我的信息有没有被正确理解、正确引用。 一个常见疑问:是不是要被AI引用,就得写得很短?不一定。长内容如果能切成小段,每段自洽,也有机会。短而空的段落,反而容易被跳过。 你平时用AI搜索时,有没有遇到过答案看着合理、一查来源对不上的情况?欢迎结合具体场景继续聊聊。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:生成式AI搜索原理:从关键词匹配到答案生成,中间发生了什么
文章链接:https://www.ttrenwu.com/geo/4234.html