同一个词,放进不同系统就可能是两个东西
比如搜索里敲个“苹果”。卖手机的想给你看 iPhone。水果店想给你看红富士。可机器一开始并不知道这两件事的区别。知识图谱与实体识别,往往就是从这里切入的。
实体识别做的是“认人认物”。从句子、标题、评论里,把公司、人名、地点、产品、时间这些对象拎出来。知识图谱做的是“记关系”。谁收购了谁,谁是谁的子公司,哪个产品属于哪个品牌。
说实话,这俩经常一起出现。少了实体识别,图谱没料。少了图谱,实体也只是孤零零的标签。

不过话说回来,很多团队一开始会把重点放在模型上。上线后才发现,脏数据、同义词、简称、别名,才是天天要面对的活儿。
实体识别听起来简单,坑点相当密
比如“小米”是公司,也是粮食。“华为”是品牌,也可能被用来指代员工群体。“朝阳”是区,也可能是人名,还可能是方向。这个可能因人而异,但上下文一换,答案就变。
常见做法是先定类型体系。人物、组织、地点、产品、事件、时间,通常够用。再根据业务加细分,比如金融风控里的“受益所有人”“关联方”。
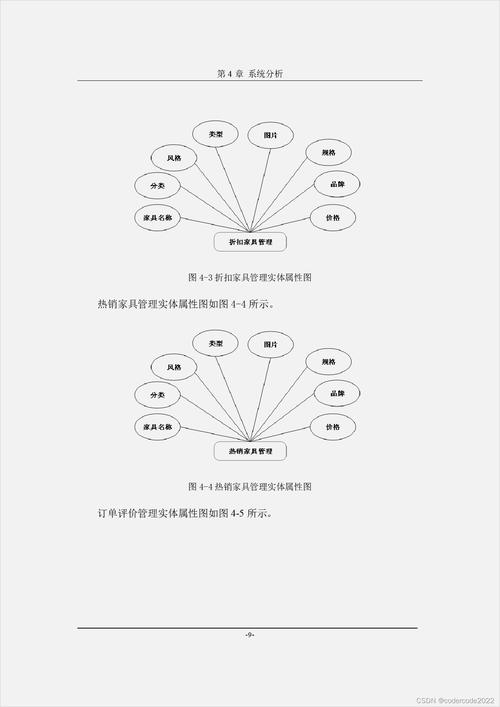
别把实体识别和实体链接混为一谈。前者是从文本里找出实体提及。后者是把提及对应到知识库里的具体条目。比如“老马”和“马云”是不是一个人,这一步更麻烦。
从实操角度看,词典和模型一起用,通常更稳。规则兜底高频词,模型处理变体。维护周期呢?看业务变化。电商大促前、金融新产品上线后,都要回头查一轮。
注意误区:只盯准确率,不看召回。只做训练,不做评估集。只认标准名,不认简称、错别字、网络黑话。
知识图谱里,实体对齐才是体力活
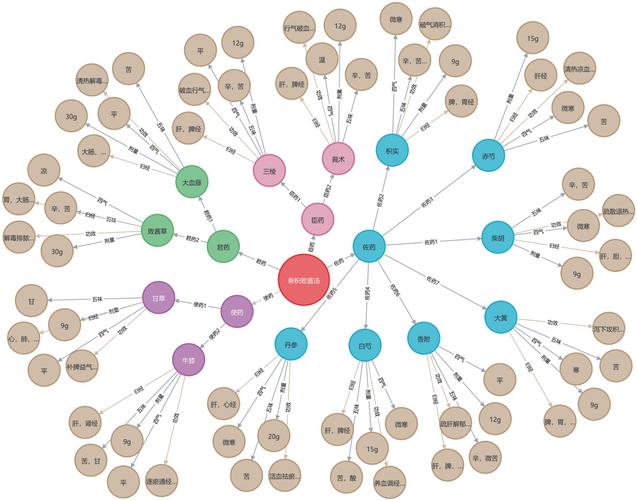
实体抽出来,图谱要连起来。可 A 系统写“北京字节跳动科技有限公司”。B 系统写“字节跳动”。C 系统写“ByteDance”。这三个是不是同一个对象?得对齐。
对齐通常分几步:标准化、去重、相似度计算、人工抽检。听起来不酷。做起来很费人。
据一些用户反馈,图谱项目前期大量时间花在清洗和对齐上。模型调优反而排在后面。这不算夸张。
保留来源和置信度,很重要。哪个实体来自工商数据,哪个来自新闻抽取,哪个是人工录入。后面追溯、纠错、合并,都靠这些线索。
还有本体边界。别一上来就搞大而全。业务问什么,先建什么。比如风控先要“公司-股东-高管”关系。医疗先要“疾病-症状-药品”关系。
评估时别只看一个数字

实体识别通常看精确率、召回率、F1。但业务里还要看边界对不对。比如“北京大学”被切成“北京”和“大学”,算不算对?要看场景。搜索场景可能不能接受。舆情监控可能勉强能用。
知识图谱评估更偏关系覆盖和查询效果。比如问“谁投资了这家公司”,返回结果是否完整。这比单纯看实体数量有意义。
还有冷启动。新领域没有标注数据,可以先字典加规则跑一版。再拿错例做标注。迭代几轮,通常能看到改善。急不得。
和向量检索、大模型怎么配合?

向量检索擅长语义相似。你说“电池不耐用”,它能找到“续航差”。知识图谱擅长明确关系。你要查“这家公司的母公司旗下还有哪些品牌”,图谱更合适。
两者不冲突。常见组合是:向量先召回,图谱再推理或过滤。大模型可以辅助实体识别,少样本也能跑。但幻觉要校验。尤其是数字、日期、金额,不能直接信。
有意思的是,很多知识图谱项目不是败在算法。是败在没人维护。实体会变,关系会变。今天收购,明天拆分。没有更新机制,图谱很快过时。
所以,先问业务问题。再定实体类型。再小范围跑通。别急着铺大摊子。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
