模型胡说八道的时候,语气往往比真话还稳。你问它一个冷门历史事件,它能给你编出日期、人名、甚至参考文献。挺气人的。反幻觉技术基础,说白了,就是想办法让这种一本正经的胡说少一点,再少一点。
幻觉从哪儿来?先别急着骂模型
它不是在数据库里查答案。它是在猜下一个词。对,就是概率游戏。训练语料里没有覆盖到的角落,它照样能顺着语言惯性往下编。比如你问某小镇2021年的降水数据,它可能组合出一个看起来很合理的数字。
另一头,提示词也会带偏。你问“为什么某公司2023年破产了”,这预设了破产事实。模型容易顺着你的假设走。据一些用户反馈,换个问法,比如“某公司2023年的经营状况如何”,回答会谨慎很多。
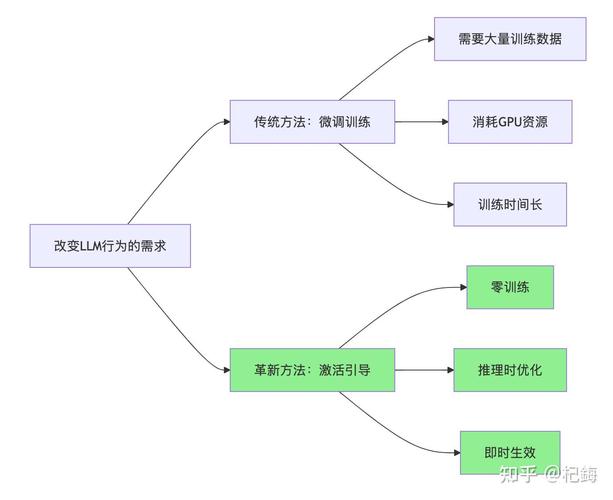
所以,反幻觉技术基础的一层,不是堆更多参数,而是承认:模型不知道的事情,得让它有机会说不知道。
检索增强:给模型一本能翻的参考书
常见的做法叫RAG,检索增强生成。流程不复杂:先把问题变成向量,去知识库里找相关段落,再把段落塞进上下文,让模型基于这些材料回答。
听起来像开卷考试,对吧?但开卷也有风险。检索错了,模型会跟着错。检索到过时文档,回答也会过时。从实操角度看,切分文档的粒度、嵌入模型的选择、重排序策略,都会影响最终效果。不是接了知识库就万事大吉。

还有一个细节:引用来源。让模型在回答里标出依据来自哪段材料,用户能核对,系统也能做自动校验。这比单纯说“请准确回答”有用得多。
训练和解码阶段的小动作:让它学会刹车
训练时,可以加入事实一致性目标。比如让模型判断两句话是否矛盾,或者用强化学习奖励“有依据的回答”。不过话说回来,这类方法成本不低,数据标注也麻烦。
解码阶段更轻量。降低随机性,温度调低一点。对事实类问题,可以要求模型先列证据再给结论。还有自一致性检查:让模型生成多个答案,再比对分歧。分歧大的地方,往往就是幻觉高发区。
有意思的是,有些团队用“认知不确定性”估计。模型自己觉得没把握,就触发外部检索或转人工。这招在客服、医疗问答里比较常见。
评测与落地:别只看流畅度
流畅不等于正确。一个回答读起来顺,可能每句话都在编。评测时得分开看:事实准确性、引用忠实度、拒答率。拒答率太低,说明模型爱逞强;太高,又可能变成啥都不答。
需要留意的是,不同场景容忍度不一样。写营销文案,幻觉可能只是夸张。做法律检索,一个编造的判例就是事故。所以反幻觉技术基础不是一刀切,而是按风险分层。
比如低风险场景,可以保留更多生成自由度。高风险场景,通常要求强制检索、引用溯源、人工复核。这些组合起来,才像一个能用的系统。
说实话,我见过不少团队一上来就调温度、换模型,结果该编还是编。先搞清楚幻觉来源,再选工具,会省很多力气。您在实际使用中还遇到过哪些幻觉案例?欢迎结合具体场景继续聊。
