先说个挺反直觉的事。很多人以为AI自己“看懂”了图片和文字。其实相当一部分时候,是背后有一群人,在一张一张地画框、打标签、填表。
那套活儿,就是结构化数据标注。
它到底在干什么
简单说,就是把非结构化的东西——一张照片、一段客服录音、一份合同扫描件——拆成字段清晰、格式统一的数据。图片里的车要框出来,标成 vehicle,顺带写上颜色、朝向、遮挡程度。
不是随手写两句描述就完事。得有预定义的字段和取值规则,否则模型压根没法用。
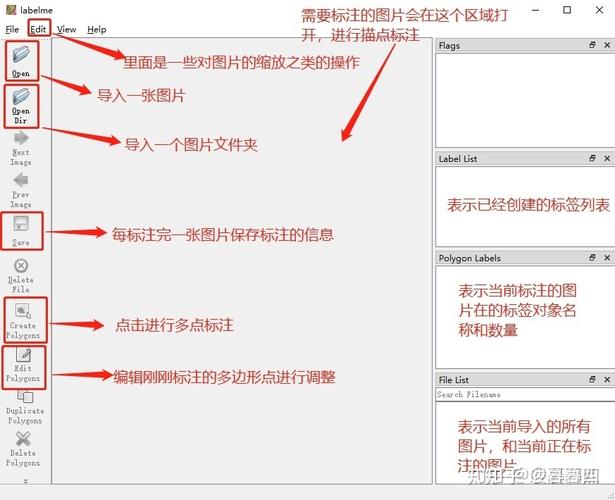
举个例子。外卖平台的调度模型想知道“这个小区门口能不能停车”,靠什么?靠骑手拍的照片里,有人把“消防通道”“临时停车位”“禁停黄线”一块一块标出来。这类标签攒够了量,模型才学得会。
再比如金融风控。合同扫描件中的甲方名称、签署日期、金额,得从PDF里抠出来塞进结构化表格。这动作看着枯燥,可它是自动审核流程的地基。
还有语音。客服录音转成文字之后,谁在什么情绪下提到了“退款”,也要标。字段可能是【说话人】【意图】【情绪强度】。
真正卡人的地方,往往不在工具上
工具其实不少。开源的有,云厂商的也有。花钱能解决的那部分,通常不是难点。
难点在标注规范的一致性。
同一张图,张三觉得该标“模糊”,李四觉得还看得清,标了“清晰”。这种偏差累积到几万条,模型就学糊涂了。所以实操里比较常见的做法是:先写一份标注手册,把边界情况写死——什么程度算模糊,什么叫部分遮挡,遇到拿不准的怎么办。
然后做交叉验证。一批数据两个人分别标,算一致率。低于某个阈值,就得回头改手册,而不是催着标注员提速。
从实操角度看,不少团队翻车不是因为模型选错了,是因为前期规范太糙。

还有几个容易踩的坑:
- 字段设计贪多。一口气列三十个字段,标注员眼睛都花了,后来大半是空值或者瞎填。
- 没有质检环节。抽检比例通常建议不低于5%,高风险场景还得更高。
- 把标注员当机器使。长时间标同一类图,疲劳带来的错误率上升几乎是必然的,需要轮换和休息。
说白了,这是个管理活,不完全是技术活。
它和几个容易混淆的概念差在哪

有人会把它跟数据清洗搞混。清洗是处理已有的脏数据,去重、纠错、补全。标注是从无到有地添上语义信息。两件事,顺序上一般先标注再清洗,也可能来回反复。
还有人把它等同于打标签。标签只是其中一种形态。结构化标注还包括关系抽取——比如“张三”是“某某公司”的“法定代表人”,这种三元组也是结构化的一种。
那现在大模型这么强,还需要人工标吗?
有意思的是,情况在变,但没消失。模型可以先做预标注,人来审核和修正,效率比纯人工高出不少。可一旦涉及专业领域——医疗影像里的病灶边界、法律文书里的条款归属——模型的判断还是得有人兜底。
据一些用户反馈,预标注加人工复核的组合能把整体成本压下来,但前期搭流程的时间反而更长了。
这个可能因人而异,取决于你的数据复杂度和团队规模。
另外提一句,隐私和合规得提前想。涉及个人信息的语料,脱敏通常在标注之前做,而不是之后补。顺序搞反,返工量会让人头皮发麻。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续聊。
