你有没有过这种经历?在搜索框里敲下‘苹果’,结果跳出来一堆手机评测,可你明明想找的是水果店。或者你问语音助手‘周杰伦老婆是谁’,它秒回‘昆凌’。这背后,实体识别和知识图谱在悄悄干活。说真的,这俩词听着唬人,拆开看没那么玄乎。
实体识别:从一句话里揪出‘谁、在哪、干了啥’
先聊实体识别。它的任务很简单:给一段文本,找出里面哪些词是‘实体’。比如‘张三昨天去了北京’,NER会标出‘张三’是人名,‘北京’是地名。就这么直接。但别小看它。中文里‘苹果’可能是水果也可能是公司,实体识别得靠上下文判断。有时候它也会翻车,比如‘我喜欢吃苹果’和‘苹果发布了新手机’,模型得学会区分。据一些用户反馈,实际项目里很头疼的是人名和机构名重叠,比如‘北大’到底指北京大学还是北大街?这个可能因人而异,但通常需要结合领域词典。
说实话,实体识别听起来简单,但实际做起来坑不少。比如中文没有空格,分词就是一道坎。‘南京市长江大桥’是‘南京市/长江大桥’还是‘南京/市长/江大桥’?不同分法,实体识别结果天差地别。再比如,网络新词层出不穷,模型得持续学习。你辛辛苦苦训好的模型,可能过两个月就被‘绝绝子’‘YYDS’搞懵了。

知识图谱:把散落的实体串成一张关系网
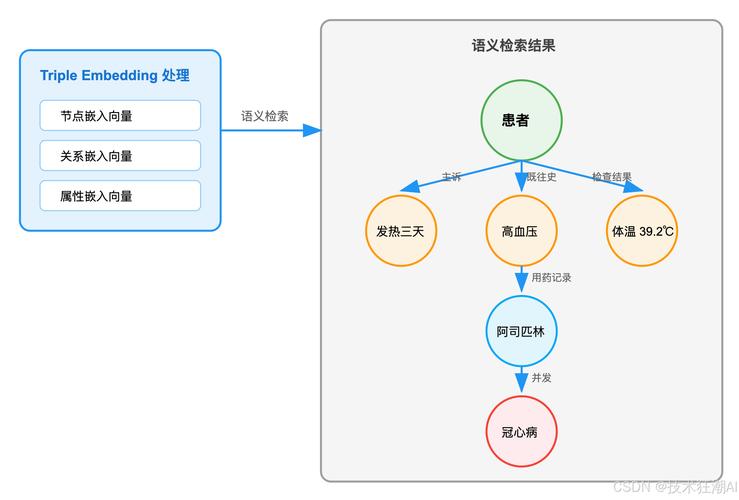
光识别出实体还不够。知识图谱要干的事,是把这些实体和它们之间的关系画成一张图。图里每个节点是一个实体,每条边是一种关系。比如‘张三-居住于-北京’,‘苹果公司-创始人-乔布斯’。这样机器就能推理:既然张三住北京,北京在中国,那问‘张三住哪个国家’它也能答。有意思的是,知识图谱不是数据库那种死板的表,它更灵活,可以随时加新节点。但建图的过程很磨人。你得先做实体识别,再做实体链接(把‘苹果’链接到知识库里的苹果公司或苹果水果),最后抽关系。每一步都可能出错,比如把‘马云’和‘马化腾’搞混,那整张图就歪了。
另外,知识图谱的存储也讲究。图数据库比如Neo4j、JanusGraph,用起来和传统关系数据库完全两码事。查询语句你写过吗?MATCH (n:Person)-[:LIVES_IN]->(c:City) RETURN n,看着像外星文。但习惯就好。常见误区:有人以为实体识别就是知识图谱。其实前者是后者的预处理步骤,相当于做菜前的切菜。没有实体识别,知识图谱就是无源之水。
这俩凑一起,能帮你干点啥?
比较常见的,搜索引擎。你搜‘刘德华演过哪些电影’,它先识别出‘刘德华’和‘电影’,然后在知识图谱里找连接,直接给你列表。还有智能客服。你说‘我要退昨天买的鞋’,它识别出‘退’、‘昨天’、‘鞋’,再查订单图谱,自动处理。不过话说回来,别指望它完全准确。实体识别在短文本、网络用语面前经常犯傻。比如‘我裂开了’里的‘裂开’不是实体。从实操角度看,如果你要自己搞一套,建议先从小领域开始,比如只做法律文书里的实体识别,别一上来就全领域。维护周期?知识图谱需要持续更新,不然新出现的实体就漏了。比如新出了一款手机,你的图谱里没有,问答系统就懵了。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。