现在搜个东西,输入“冬天久坐脚凉怎么办”,出来的结果全是卖加热脚垫的链接,根本找不到“办公室脚冷有没有低成本小妙招”的实用回答——这就是传统关键词检索没做到位的地方,而语义检索与匹配要解决的,就是这种“说人话却搜不对内容”的痛点。
语义检索与匹配到底解决了什么日常问题
你在公司内部知识库找“去年Q3给华东客户做的售后赔付规则”,传统检索会把请求拆成“Q3、华东、售后赔付”几个独立关键词,可能搜出来一堆华东区销售合同、Q2的赔付通知,根本不是你要的。
而语义检索与匹配会识别你真正的需求:找对应时间、对应区域、对应规则类的文档。它不会硬卡你有没有写某几个固定的字,能识别“脚凉”和“下肢保暖”是同一类需求,也能懂“找赔付规则”和“查售后标准”是同一个意思。
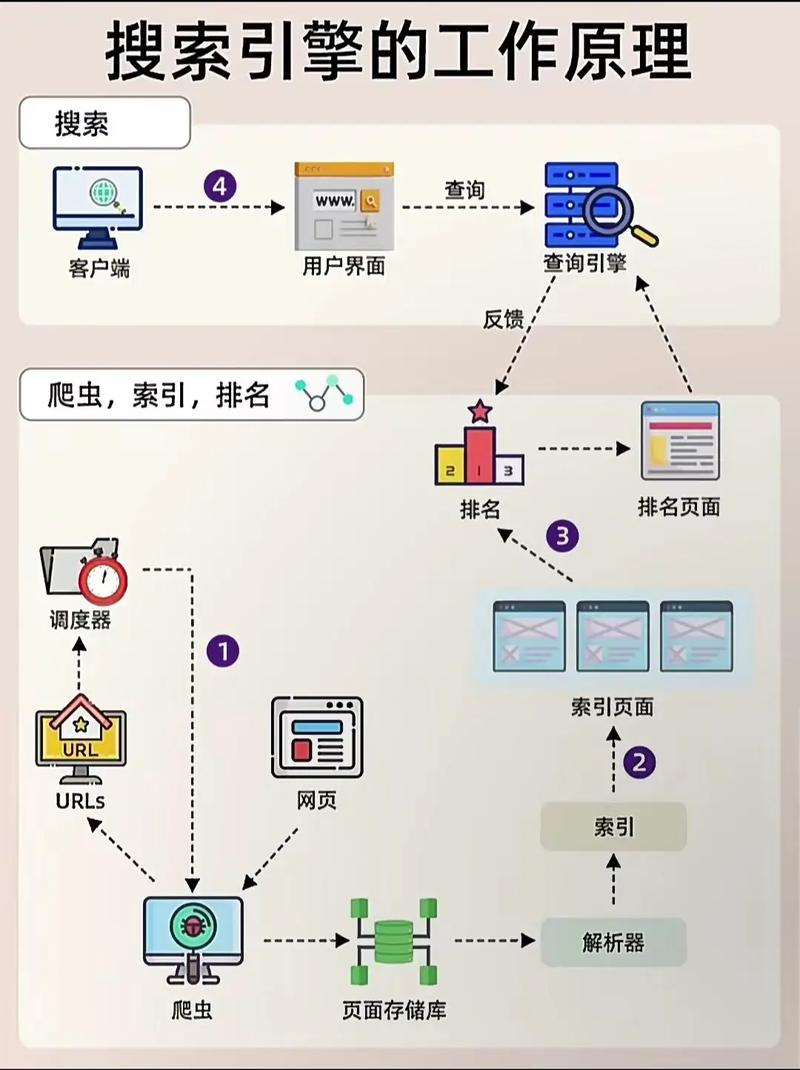
 语义检索与关键词检索结果对比示意图
有意思的是,现在很多手机本地的文件搜索已经在用这套逻辑了——你搜“上周拍的猫在沙发上睡的照片”,不用记得照片的文件名,系统也能把对应的图找出来,本质上就是给图片、文本做了语义层面的关联。
实操里容易踩的几个误区
很多人刚接触这套功能,会以为只要上了语义检索系统,搜什么都能准。其实不是。
如果给系统喂的内容本身语义标签混乱,再好的检索模型也会出乱子。比如你把“员工差旅报销标准”的文档,随手存到了“办公室采购规则”的文件夹里,哪怕模型再懂语义,也没法把用户搜“出差住酒店能报多少钱”的请求和这份错放的文档匹配上。
据一些用户反馈,刚上线语义检索系统的头两周,匹配准确率往往比预期低30%左右,大半原因是之前的存量文档分类太乱,没有做基础的语义标注。
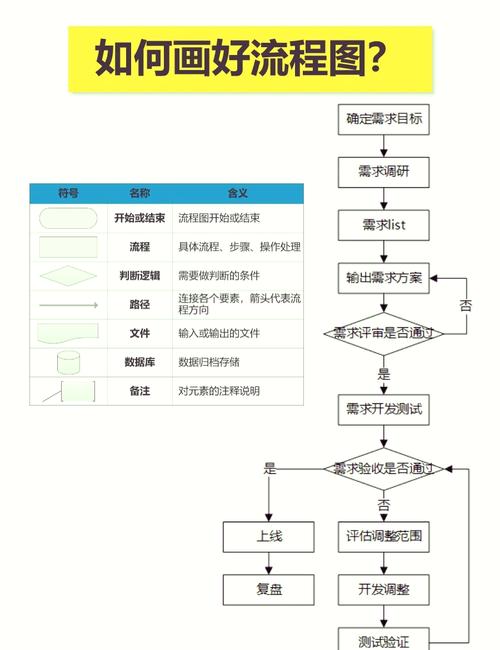 企业知识库语义标注流程示意图
还有个常见坑:别把语义检索当成“万能搜”。如果你的语料库里根本没写“2024年差旅报销里高铁一等座的适用人群”,系统就算语义理解再强,也不会凭空编出答案——这点和传统检索的边界是一样的,输出内容永远基于已有的可访问语料。
和传统关键词匹配的核心差异在哪
 和传统关键词匹配的核心差异在哪
传统匹配走的是“字面对等”的路子。比如你搜“手机充电慢”,它会优先找带“充电慢”三个字的内容,哪怕某篇文章写的是“电池健康度低于80%会导致充电速率下降”,因为没出现“充电慢”这三个字,可能排到很后面。
语义检索与匹配会把两者的关联关系打通,知道后者的内容正好能回答用户的问题。现在很多内容平台的推荐逻辑,其实也融入了这套思路——你看完一篇讲“租房退租怎么扣押金”的内容,后续给你推的不是全带“退租押金”的文章,可能是“租房合同里的隐形条款”“和房东谈退租的沟通技巧”这类关联内容,本质上就是在匹配你潜在的语义需求,而不是卡着你之前的搜索关键词。
您在实际使用搜索工具、搭建内部知识库的过程中,还遇到过哪些检索不准的情况?欢迎结合具体场景继续探讨。