基础认知:知识图谱和实体识别到底是什么
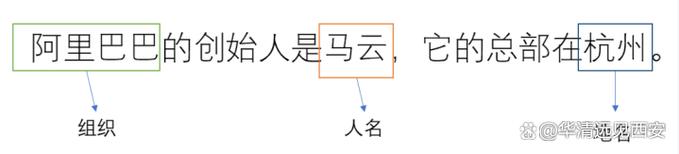
简单说,实体识别是「分拣员」,先从大段的文本、语音转写内容里,把有明确意义的独立单元——也就是实体给抠出来,比如人名、品牌名、地址、事件名这些。
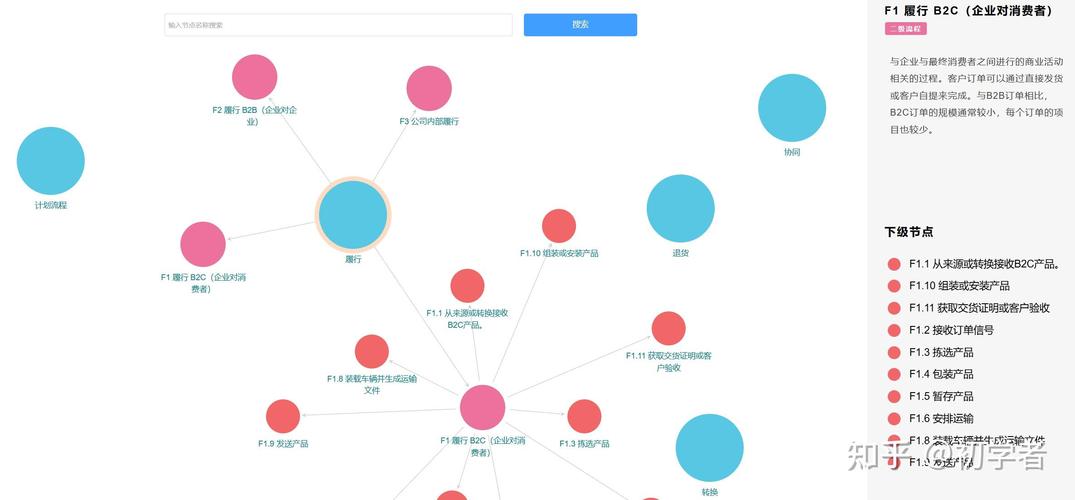
知识图谱就是「整理架」,把抠出来的实体,按照彼此的关系连在一起,形成一张可以随时检索的关系网。
举个例子,你在电商平台搜「苹果手机充电器」,实体识别会先分出三个实体:苹果、手机、充电器,知识图谱马上调出「苹果做手机」「手机需要搭配对应充电器」的关联关系,直接给你推匹配的商品,而不是给你出一堆关于苹果水果的内容。
实操里需要留意的常见问题
第一个坑是忽略实体消歧。很多刚接触的团队,只做到把词抠出来就停了,遇到多义词直接懵。
比如「小米」可以是谷物、数码品牌、人物名字,「南山」可以是地名、公司名、奶粉品牌,不对歧义做区分,出来的结果错一大片。
第二个坑是做完知识图谱就一劳永逸,不再维护更新。说实话,实体和关系一直都在变。
据一些用户反馈,不少企业三年前搭好的内部知识图谱,现在超过三成的合作关系、岗位信息都已经不对了,用起来反而添乱。
普通开发者的入门思路
现在不用从零开始训练模型。开源社区有不少训练好的通用实体识别模型,可以直接拿来适配自己的场景。
如果是垂直领域,比如医药、法律这类专业方向,通常只需要加几百条自己标注的领域数据微调一下,准确率就能提上来。
从实操角度看,用大模型辅助标注实体,比纯人工标注效率高很多,成本也降了不少,适合中小团队试手。
您在实际搭建或使用知识图谱与实体识别的过程中,还遇到过哪些特殊情况?欢迎结合具体场景继续探讨。
