现在不管是用AI写方案、查资料,甚至是问它专业领域的细节问题,最怕的就是它一本正经编不存在的文献、凑没有来源的数据,反幻觉技术就是冲着这个问题搭建的整套基础应对框架。
先搞懂:幻觉通常在啥场景下冒出来
很多人对AI幻觉的印象,是那种离谱的常识错误。比如把“珠穆朗玛峰高度8848米”说成88480米。
实际上更常见的幻觉,是半真半假的内容。你问AI“2023年国内新能源车企的平均售后响应时长”,它根本没对接实时公开数据库,就顺着语义编一个“约2.8小时”的数,连参考来源都编得像模像样。
说实话,这种半真半假的内容很容易让人放松警惕。比如你让它写行业报告,它列的参考文献一半是真实存在的核心期刊,一半是根本搜不到的假论文,普通读者很难逐一分辨。
据一些公开的用户调研反馈,约六成的日常使用场景里,幻觉都出现在需要精确数据、特定来源内容的提问中。不是AI故意骗人,是它的训练逻辑本来就是匹配更通顺的语义关联,不是检索更准确的客观事实。
较为常用的几个基础反幻觉操作逻辑
第一个核心操作是检索增强生成(RAG)的基础应用。别让AI凭训练时的“记忆”答题,先把你手里的可信资料喂给它,要求它只在给定资料的范围内组织语言,碰到资料外的内容直接说明“没有相关信息”,不能顺着语义瞎编。
举个例子,做内部制度答疑的AI,就把公司的考勤规则、报销流程的正式文档全部导入专属知识库,AI回答的时候必须标注引用的文档页码,从规则上断掉它瞎编的路径。
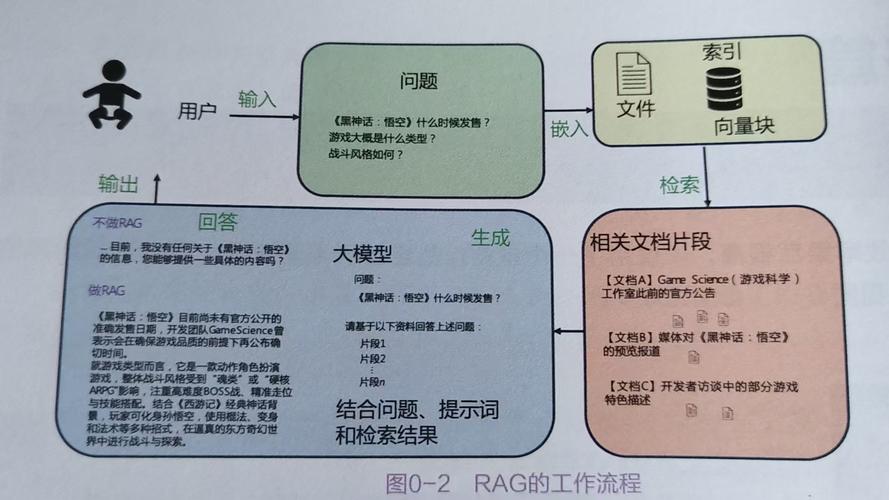
需要留意的是,这个方法不是万能的。如果导入的资料本身有错误,AI还是会顺着错的内容输出,技术本身没法自动判断资料的对错。
第二个基础操作是输出环节的前置事实校验。就是AI生成内容之后,专门加一道独立的校验程序,把内容里提到的实体、数据、引用来源挨个去可信数据库比对,对不上的内容就标红提醒,不直接把生成结果丢给用户。
有意思的是,很多人一开始做反幻觉的时候,会把校验环节搭得层层嵌套,既要查文献来源,又要核对数据出处,最后把响应速度拖得特别慢,反而影响日常使用体验。从实操角度看,先把涉及数字、人名、机构名的内容筛出来核对,就能挡掉大半的低级幻觉,还不会把响应速度拖得太慢。
几个容易踩的认知误区

别觉得上了反幻觉技术,就能让AI完全不输出无依据内容。这是不现实的。技术能做的是降低幻觉出现的概率,不是消除所有可能的输出错误。
不少人迷信大参数模型的效果,觉得模型参数堆得够多,幻觉自然就少。但从行业普遍观察来看,参数规模和幻觉出现的概率没有直接的负相关关系,甚至有些超大模型因为生成的内容更流畅,编出来的东西反而更像真的。
还有人觉得反幻觉就是给AI加一堆“不许说谎”的提示词,比如在提问的时候加一句“你必须说真话,不许编内容”。实际上从实操经验看,这类提示词的作用非常有限,AI还是会顺着训练逻辑生成内容,只是表面上的措辞变了而已,核心的生成逻辑没有变化。
还有个常见的误解,就是把反幻觉等同于“让AI变聪明”。不对,很多基础的反幻觉操作,反而会让AI的回答看起来“变笨”——比如碰到资料里没有的内容,它直接说“我不知道”,而不是凑一大段通顺的废话,不少用户一开始还不适应这种输出风格。
您在实际使用AI的过程中,还碰到过哪些让人哭笑不得的幻觉场景?欢迎结合具体情况接着聊。
