知识图谱与实体识别,是现在各类智能搜索、推荐系统能读懂用户真实需求的核心底层能力。你搜“家附近开了三年的老面馆”,系统能精准跳出对应店铺的位置、招牌面、用户评价,靠的就是这套技术的配合。
日常场景里的真实落地
很多人听到这俩词觉得离自己很远,其实每天都在接触。
实体识别的核心作用,是从非结构化的自然语言里,把具备独立指向的单元精准抠出来。比如你在美食平台留下一句评价“巷口那家老面馆的辣肉面,比商圈里的连锁品牌够味”,实体识别要做的,就是把“巷口老面馆”“辣肉面”“商圈连锁餐饮品牌”这些有明确指向的内容标出来,而不是把“上周”“好吃”这类通用描述算成实体。

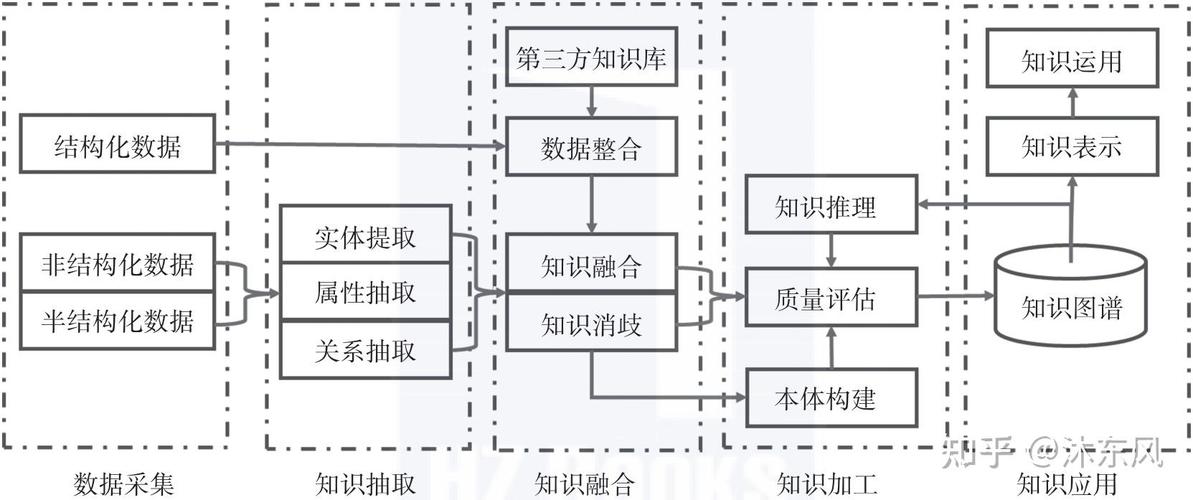
知识图谱则是给这些抠出来的实体牵线搭桥——给老面馆关联上具体地址、开店年限、招牌菜品、用户提到的对比对象,形成可检索、可关联的结构化知识网络,而不是把零散的文字堆成无意义的数据库。
实操中容易踩的共性误区
说实话,见过太多团队图省事,拿通用模型直接套垂直场景,最后出来的结果根本没法用。
别觉得买个现成的模型就能搞定所有场景。从实操角度看,很多团队一开始只拿通用模型做实体识别,遇到垂直领域的专属名词就容易出错。比如做中医药领域的知识图谱,通用模型可能会把“茯苓桂枝汤”识别成普通食材,根本关联不到对应的方剂、适用人群。这很要命。
没有经过消歧的实体,塞进知识图谱只会制造检索噪音。比如“苹果”可以是水果,也可以是消费电子品牌,没有上下文锚定的实体,会让搜索结果完全跑偏。据一些用户反馈,没做歧义消歧的知识图谱,搜索匹配的误差率比做了消歧的高40%以上。
和大模型能力的边界差异
很多人会把大模型内置的知识和知识图谱搞混。大模型的知识存储在参数里,遇到训练集没覆盖的新名词,容易生成不符合事实的内容。知识图谱的每个实体节点都能标注明确的信息来源,比如查药品适应症,节点可以直接关联公开的监管公示文件,溯源性更强。
现在较为常见的落地方式,是用大模型做初步的实体抽取,再把抽出来的实体灌入知识图谱做关联校验,比单独使用某类技术的适配性更好。
您在实际使用相关技术的过程中,还遇到过哪些识别偏差、关联错位的情况?欢迎结合具体场景继续探讨。
