很多人用大语言模型查资料时,看到答案末尾挂了链接,就默认内容靠谱。
真不是。
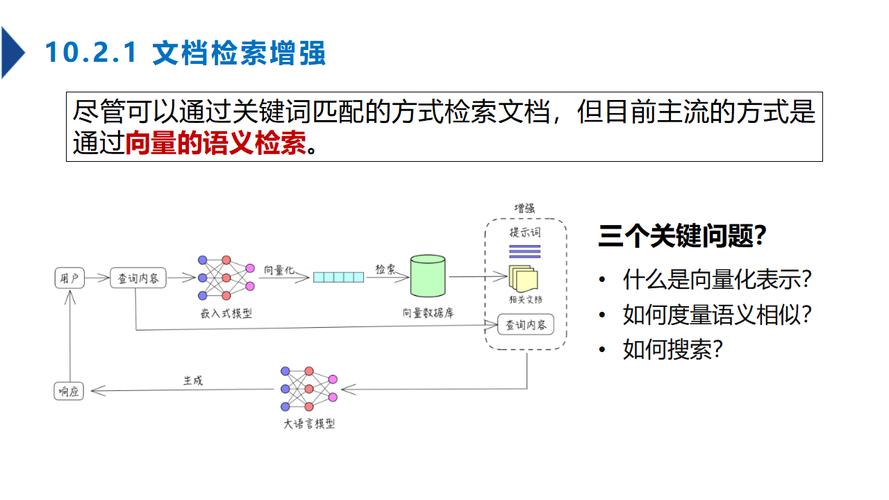
到底什么是大语言模型的引用机制
说白了就是模型在联网检索到公开信息后,把对应内容的来源链接,标注在生成答案的对应内容旁边,让你能顺着链接核对原始信息。
如果是没触发联网检索的纯生成内容,模型通常不会加引用,这类内容如果涉及具体数据、政策、案例,就要多留个心眼。
举个例子,你问“2024年国内公共充电桩的平均覆盖率”,模型如果触发了联网检索,就会把查到的交通运输部公开报告、行业调研文章的来源,标在对应数据的旁边。
说实话,我之前用某款模型写行业分析的时候,没注意引用标的位置,直接把没标来源的行业数据抄进了报告。
后来被领导指出来是模型瞎编的。
尴尬到抠脚。
实操时经常被忽略的几个细节
要知道,不是带了引用的内容就可以直接信。
据一些用户反馈,有些模型会把检索到的旧数据,套到新的问题场景里,哪怕标了来源,来源本身的时效就不对。比如你问2025年的新能源补贴政策,它引了2023年的旧文件,挂了链接也没用。
引用和内容的对应关系才是核心,不是答案末尾堆一堆链接就算完成了引用。比如你问某款新护肤成分的临床测试结果,模型把测试数据写得头头是道,末尾却引了一篇完全不相关的品牌宣传稿,这种引用就是凑数的。
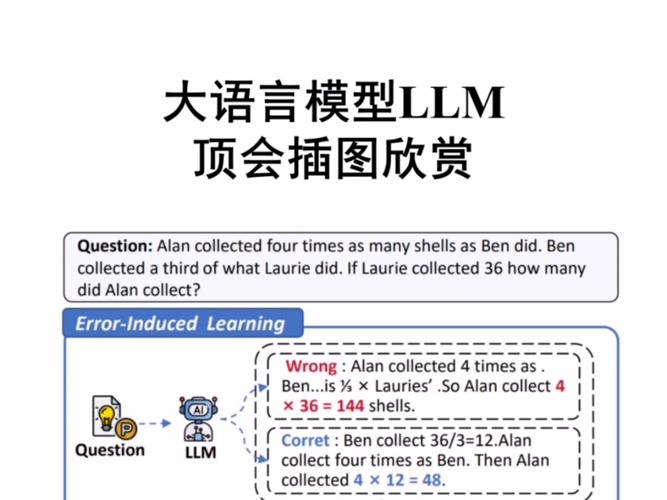
有意思的是,现在有些模型的引用是检索完就自动挂的,根本没做内容匹配。
相当于给瞎编的内容盖了个“有来源”的章。
当前引用机制的普遍局限
从实操角度看,现在大部分模型的引用,只能跳转到公开可访问的网页,要是来源是付费数据库、内部文档,就没法做精准标注。
比如很多人用模型查学术文献的时候,它标了个知网的链接,点进去发现是期刊的主页,根本不是提到的那篇具体论文的对应段落。
而且现在的引用大多是标整个网页的来源,没法精准定位到网页里的具体段落。你要核对内容,得自己在长网页里翻半天,很费时间。
你平时用大语言模型的时候,遇到过哪些引用不靠谱的情况?欢迎结合具体场景继续探讨。
