2026-11-02 07:33:02 分类:GEO优化
语义检索与匹配是现在企业知识库、智能客服、站内搜索里较为常被提到的落地技术之一,不是那种飘在天上的大模型概念。
先搞懂:它到底在解决什么问题
你在公司知识库搜“年假能拆成半天请吗”,以前的关键词匹配会跳出来带“年假”“半天”的文件,但可能根本没说拆分规则。
语义检索会直接定位到《员工休假管理细则》里“年假可按0.5天为最小单位拆分申请”的条款。
说实话,我之前帮一家零售公司搭内部搜索的时候,就碰到过老系统的问题:销售搜“客户退鞋要带什么”,老系统给推了30多篇讲鞋类库存的文档,根本没人看。换成语义检索之后,结果直接跳退换货流程的条目,客服的咨询量直接降了快两成。对吧?
和传统关键词匹配的核心差异,是它不是找字面完全重合的内容,而是匹配语义层面的真实意图。
 传统关键词匹配与语义检索结果对比示意图
落地时较为常见的几个坑
别偷懒。
很多团队刚上语义检索的时候,会觉得只要把所有历史文档一股脑导入向量数据库,等着系统自动完成匹配就完事,往往忽略了文档本身的质量问题。比如你把扫描版的旧合同直接丢进去,OCR识别的错字会直接把向量偏差拉得很大,检索出来的内容驴唇不对马嘴。
要做分层的知识库切分,不能整本书丢进去。比如一份100页的员工手册,要按章节拆成100字到300字的独立片段,不然检索出来的内容会混着不相关的条款。
从实操角度看,切分片段的长度如果超过500字,语义匹配的准确率通常会掉15%左右。
 企业知识库文档切片处理流程示意图
和普通向量检索的区别在哪
 和普通向量检索的区别在哪
很多人觉得语义检索就是向量检索,其实不然。
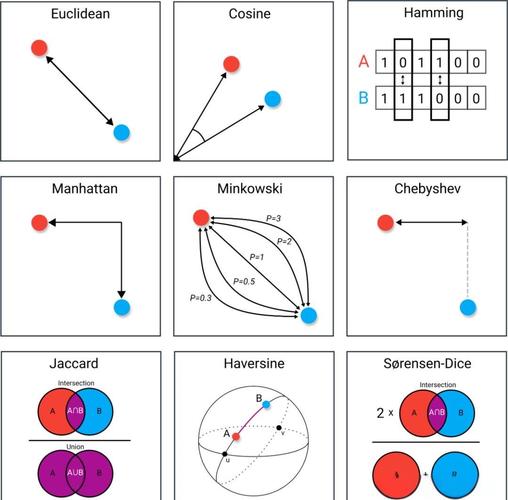
向量检索是计算文本之间的余弦相似度,但是真正好用的语义匹配,会加一层规则校准——比如当用户问的是涉及金额、时间的问题,会优先匹配带明确数值的片段,而不是相似度最高的泛泛而谈的内容。
举个例子,用户问“今年的团建预算是多少”,如果只靠向量相似度,可能会跳出去年团建的活动照片文案,加了校准规则之后,会优先定位到带“预算”“2024”“金额”标签的文档片段。
有意思的是,很多对外宣传说自己用了语义检索的产品,实际只做了较为基础的向量相似度计算,根本没做规则校准,用户用起来的体验和老的关键词搜索差不了多少。
你在搭内部搜索或者知识库的时候,碰到过哪些检索结果不匹配的糟心事?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:语义检索与匹配:从站内搜索到知识库的落地实操要点
文章链接:https://www.ttrenwu.com/geo/3564.html
