你刷电商搜“适合混敏皮用的防晒霜”时,系统能精准把你匹配到对应商品、成分、测评内容的逻辑,大半和知识图谱与实体识别脱不开关系。
藏在日常里的基础认知
很多人觉得这俩概念是互联网大厂的专属技术,其实早就渗透到日常用的各种工具里了。
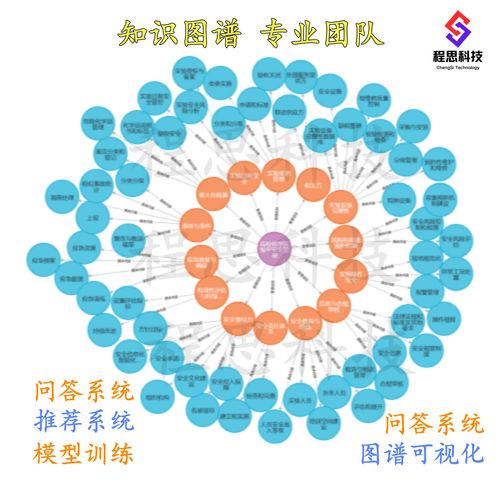
比如你在本地政务APP查“灵活就业社保缴费”,系统能直接关联到你所在区的经办点、缴费比例、办理材料。这背后的逻辑很顺:先把查询语句里的核心身份要素——也就是“实体”——从大段文字里精准抠出来,再把这些实体之间的关联拼成可随时调取的知识网络,也就是知识图谱。
实操里容易踩的几个误区
从实操角度看,很多刚接触的团队很容易犯的错,就是把“实体识别”做成了“关键词收集”。
别贪多。不是所有出现在文本里的名词都值得存进图谱。比如做本地美食的知识图谱,要是把“店老板今天穿了蓝色外套”这种和消费决策完全无关的内容都标成实体入库,后续检索的冗余度会大幅提升,响应速度也会受影响。
错配真的很烦。还有个高频问题是实体消歧做不到位。同样是叫“张三”的人,可能是老城区开了二十年的面馆老板,也可能是本地作协的青年作者,要是没给每个实体加上明确的属性标签,很容易出现内容错配。
和你固有印象有偏差的延伸视角

说实话,很多人会把实体识别和传统的关键词抓取划等号,其实两者的核心差异很明显。关键词抓取只是统计高频出现的词汇,实体识别是要明确每个词汇的“身份坐标”——它是个经营主体?是个地理点位?是个有特定功效的产品成分?
据一些用户反馈,刚开始接触时总想着直接调用通用大模型的接口就能搞定所有识别需求,实际上在医疗、法律这类垂直领域,通用模型对专业术语的识别准确率往往达不到业务要求,需要结合行业专属的标注数据做适配调整。
有意思的是,现在不少小团队做轻量化的知识图谱时,根本不需要从零开始训练模型,只要基于通用接口做少量的自定义实体标签配置,就能满足本地生活、企业内部知识库这类场景的需求。
你在实际使用相关技术的过程中,还遇到过哪些印象深刻的错配场景?
