你有没有过搜了三页结果,才发现之前卡壳的信息其实就藏在某个没写对关键词的文档里?这就是语义检索与匹配要解决的日常痛点。
它到底解决了什么日常问题
传统关键词匹配的逻辑,是你搜什么字,就找文档里出现对应字串的内容。
比如你搜“怎么给猫喂化毛膏”,老系统只会优先推标题、正文里堆了这几个字的帖子。
别不信。
语义检索能识别你要找的核心需求,把“猫咪排毛的实操方法”“猫草和化毛膏怎么搭配”这类没完全堆关键词的内容,也拉到结果列表前面。

说实话,之前用老的检索系统找内部文档,我找了快半小时才发现,大家早就把相关注意事项写在季度复盘的边角备注里了,就因为我当时搜的关键词和文档里的表述差了三个字。
实操里容易踩的几个坑
不是所有场景都适合上语义检索。
比如你找公司内部的制度文件,涉及精确编号、固定条款的内容,纯靠语义匹配反而可能把相近但不相关的内容混进来。
据一些用户反馈,很多团队刚上线语义检索功能时,会把所有历史文档一股脑塞进去,结果出来的匹配结果杂七杂八,反而降低了找东西的效率。
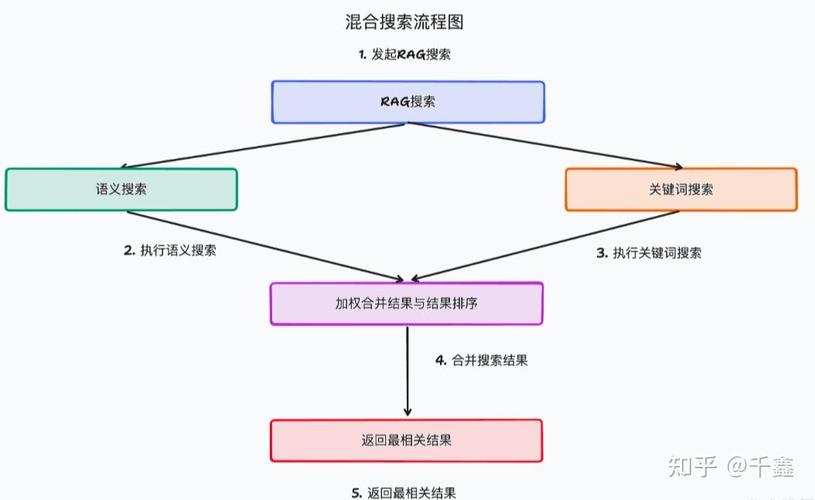
语义匹配的准确度,和提前做的语料清洗直接相关。
如果文档里堆了太多行业黑话、缩写,又没有做对应的标注,系统很容易把“用户留存”和“用户留存率”当成完全不相关的内容,匹配错方向。
需要留意的是,语义检索不是万能的,它只是帮你缩小找信息的范围,不是直接给你标准答案。
和你之前认知的差别
很多人以为语义检索就是“把句子丢进大模型算相似度”。
从实操角度看,现在多数落地的语义检索系统,是把文本拆成带语义向量的片段,匹配的时候先算向量距离,再把最相近的片段拼起来,不是等大模型逐字逐句读完全部文档。
举个例子,你问“上个月华东区的客户投诉主要集中在哪些问题”,系统不会把整个华东区的月度报告全读一遍,而是先定位到带“投诉”“问题”标签的文本块,再在这些块里匹配和“华东区”相关的内容,速度比纯大模型全文检索快很多。
你在实际用检索工具找信息的时候,还遇到过哪些答非所问的情况?欢迎结合具体场景继续探讨。
