我们平时搜“北京朝阳门附近的卤煮店”能跳出精准结果,背后就绕不开知识图谱与实体识别的配合。
基础认知:给零散信息“认脸”的基础环节
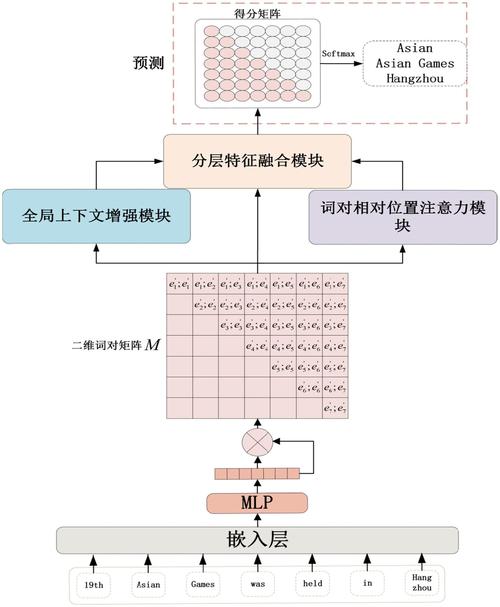
实体识别说白了,就是从一堆没有结构的文本里,把具体的人、事、物、地点精准挑出来。比如你刷到一条朋友圈“上周和老张在上海看了流浪地球2,周边手办质量真不错”,实体识别能快速摘出“老张(人物)、上海(地点)、流浪地球2(影视作品)、周边手办(商品)”这几个核心信息点。
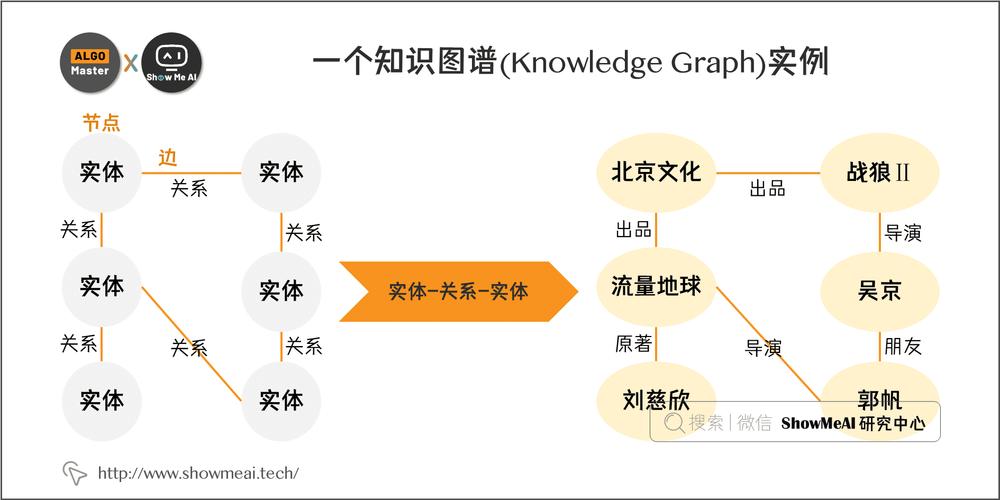
知识图谱就是把这些摘出来的独立信息点,按真实世界的关联串成可检索的网络。比如老张是某互联网公司的产品经理,上海是他的常驻工作地,流浪地球2的出品方是郭帆工作室,周边手办的授权渠道有明确的合作协议。
实操踩坑:别上来就搭复杂系统
很多人刚接触这套技术的时候,总想着要覆盖所有类型的实体,结果模型跑了三个月,准确率还卡在及格线上下。
真没必要。
从实操角度看,通常先把你核心的3-5类高频实体列出来——比如做餐饮点评的,先把“门店、菜品、商圈、人均价位”这几类做准,比你同时要识别“食客、供应链品牌、网红探店博主”的泛化方案落地效率高很多。
还有个容易忽略的点:实体识别不是一次训练完就不用管的。比如去年大家高频讨论的“新冠”,今年更多聊的是“支原体感染”“甲流亚型”,这些新冒出来的实体如果不及时补进训练集,模型识别的准确率会掉得很快。据一些用户反馈,保持每2周更新一次增量实体库,比每季度做一次全量重训的综合成本低30%左右,实际运行效果还更稳。
容易混淆的边界:别把它和全文搜索划等号
不少人觉得,我搭了个带全文检索的数据库,不就是知识图谱了?
真不是。
全文搜索是只要文本里出现匹配的关键词就返回结果——比如你搜“苹果”,它能跳出卖苹果手机的、卖红富士苹果的、甚至叫“苹果”的社区宠物店的所有相关内容。但知识图谱配合实体识别,能先判断用户这次搜索的“苹果”是指水果、科技品牌还是地名,再顺着关联关系推送匹配度更高的结果。
有意思的是,现在很多电商平台的智能客服,就是靠这套逻辑接住用户跳脱的提问——不管是问“14Pro的电池容量多大”,还是问“烟台苹果几斤包邮”,都不会出现答非所问的情况。
您在实际使用中还遇到过哪些识别不准的特殊场景?欢迎结合具体情况继续探讨。
