平时你在相册里搜“去年海边穿红裙子的照片”,或者在短视频平台找“带猫弹钢琴的15秒片段”,用到的就是多模态内容检索的核心能力。
日常接触的多模态检索,其实离你很近
它的应用场景比很多人想象的广。比如新媒体运营团队管理素材库时,输入“三月武汉大学樱花配江南丝竹的10秒短视频”,系统能直接跳出符合要求的素材,不用运营分别找樱花素材、找音乐再手动拼接。
说实话,很多人用了大半年手机的相册搜索功能,都没意识到这不是靠预先打标签实现的。
用多模态检索容易踩的几个坑
很多人第一次用的时候,会输入非常模糊的检索词,比如只搜“好看的风景”,出来的内容往往和预期偏差很大。这点很多人没概念。
还有,要是待检索的内容本身清晰度很低、或者带有大面积水印、遮挡,匹配的准确率通常会下降。
据一些用户反馈,给检索词加上时间、特定场景、核心元素的限定,匹配精度会提升不少。需要留意的是,目前不少工具还没法精准识别方言语音、或者非常小众的艺术风格,检索的时候不用抱过高预期。
和普通关键词检索的核心差异
普通的关键词检索,本质是匹配预先给内容打的文本标签,比如你搜“橘猫”,只能跳出标签里明确标注了“橘猫”的内容。
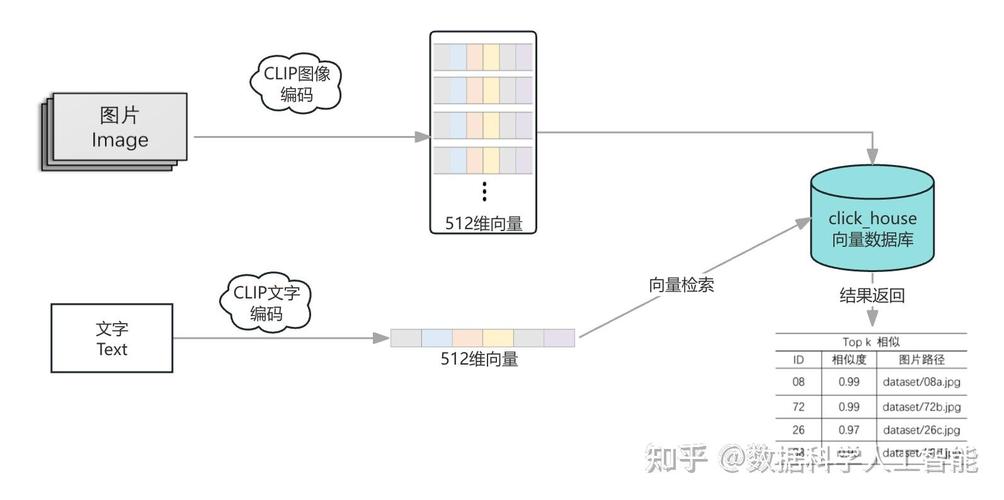
多模态检索是直接识别内容本身的视觉、音频、语义特征,不需要预先给每一条内容打文本标签,哪怕一张图从来没被人加过“橘猫趴在窗台晒太阳”的标签,只要图里真的有这个场景,就能被检索到。
这个可能因人而异,做素材库管理的团队会觉得它能大幅减少重复劳动,普通用户可能只是觉得找旧照片、找片段的时候少翻了好多页。
您在实际使用中还遇到过哪些检索不准的情况?欢迎结合具体场景继续探讨。
