你刷到的本地美食地图、AI客服能精准接住你说的退换货需求,背后大多藏着结构化数据标注的功劳。
藏在日常里的落地场景
很多人以为这是技术团队才碰的专业活,其实早就在我们的日常浏览里出现了。
比如外卖平台给每个商家打上“支持堂食”“可带宠物入内”“人均20-30元”的标签,这就是较为常见的结构化标注。
再比如做自动驾驶测试的团队,给道路上的行人、护栏、红绿灯分别标上对应的识别框,把这些规整的数据喂给模型学习,也是这类工作的范畴。
说白了,就是把零散的非结构化信息——比如一段没有格式的商家介绍文字、一张拍了街景的照片,按照统一的规则整理成机器能直接读懂的、带明确属性的规整数据。没有这步,机器根本没法从一堆杂乱的信息里快速抓出有用的内容。
实操时容易踩的几个常见误区
说实话,很多团队刚开始做这块的时候,都容易犯“规则拍脑袋定”的毛病。这个真的踩过坑才知道疼。
别小看这步。
之前碰到过做家居电商的团队,给商品标“适合小户型”的标签,没有统一的面积阈值,有的标注员觉得60平以下算,有的觉得90平以下都算,最后出来的数据喂给推荐模型,推的东西完全不对板。
通常来说,正式开标注之前,得先把每个标签的判定标准写得足够细,细到没有模糊空间。统一的判定规则,是标注数据能用的核心前提。
还有个容易走偏的点,不是标注的标签越多越好。比如给普通的一次性水杯标上“生产批次溯源”“原材料成分”这类和用户浏览决策无关的标签,只会平白增加标注成本,对模型训练的帮助很小。要始终记得标注的成本与实际价值匹配。
据一些做中小团队数字化的用户反馈,刚开始做标注的时候,抽10%的已标注数据做交叉校验,能把整体标注的误差率降不少,不用一开始就追求全量校验增加工作量。
和普通打标签的核心差异
很多人会把结构化数据标注和平时给文章加个“热点”“科技”的标签混为一谈。
其实差得挺多的。
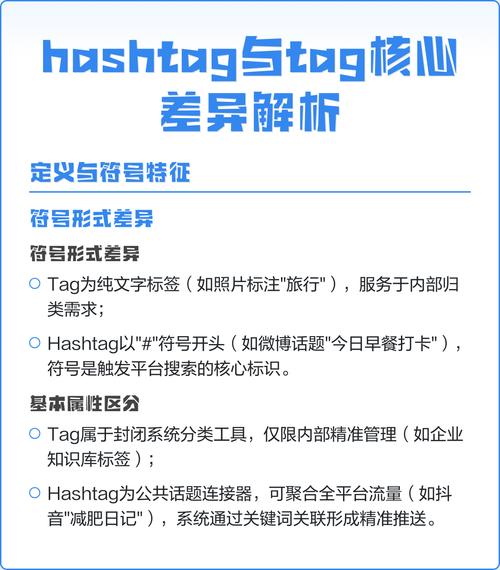
普通的内容标签更多是给人看的,只要大致符合分类逻辑就行;但结构化数据标注是给机器读的,除了做基础分类,还要把每个属性的对应值、层级关系、关联逻辑都理清楚。
举个例子,同样是标注一篇关于露营的文章,普通标签可能就打个“户外”“休闲”;但结构化标注会明确标“内容主题:露营装备推荐”“提及商品:天幕、折叠椅”“适用场景:郊野露营”,甚至会标清楚文中提到的装备价格区间,这样搜索引擎或者推荐系统才能直接把内容匹配给正在找露营装备的用户。
你在实际做数据整理或者模型训练的过程中,还遇到过哪些标注相关的难题?欢迎结合具体场景继续探讨。
