现在刷AI搜索找资料,点进去能跳转到原出处的结果,背后靠的就是大语言模型引用机制在托底。
日常使用里的引用机制到底在干嘛
之前查2024年国内新能源车冬季续航测试数据,早年的AI回答只会甩一堆干巴巴的数字,转头就可能把媒体测评的实验室数据当成官方标称值。现在每段事实性内容后面跟着个小角标,点了直接跳去对应的原测试报告页面。
说实话,之前被AI编的假论文坑过的人,看到这个角标真的会松半口气。
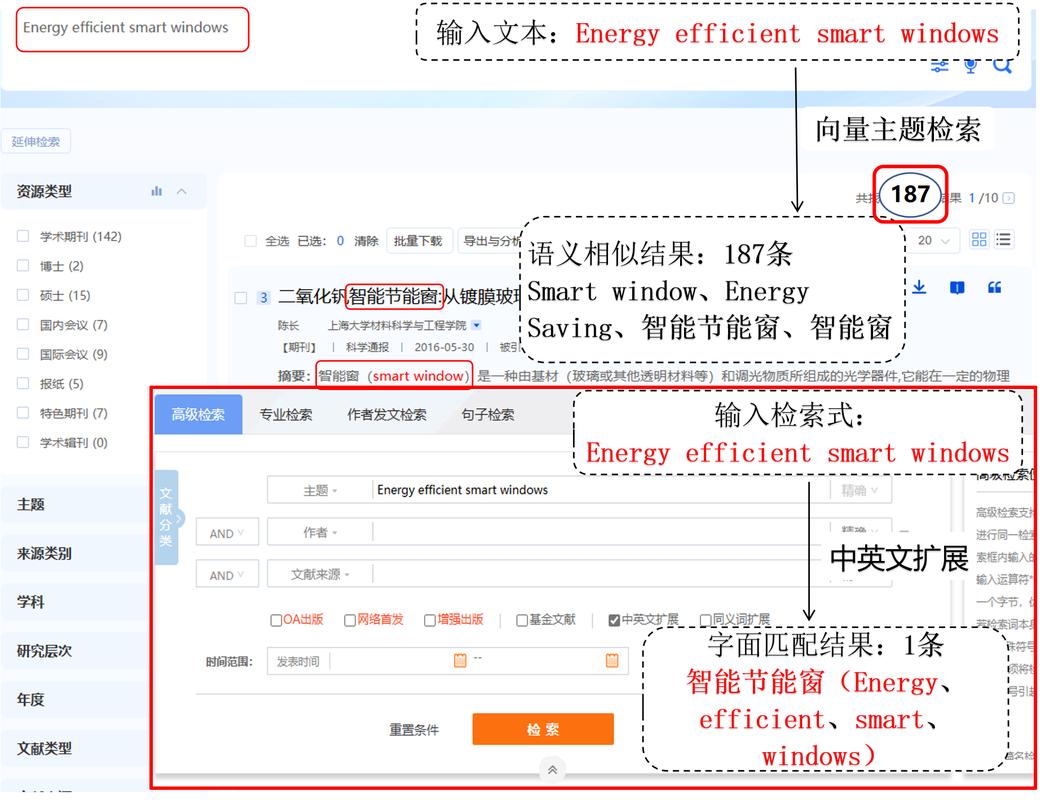
这个机制本质上不是大模型凭空捏造来源。它是在生成回答的每一句事实性内容时,自动匹配实时检索到的公开内容出处,把对应来源的链接、标题挂在内容末尾,帮用户溯源核对。
用的时候容易踩的几个坑
不是带了角标的内容就一定靠谱。
据一些用户反馈,经常遇到大模型把同一段内容的引用挂错位置——比如把”某研究显示人每天喝8杯水更健康”的标注,挂到了”某研究指出过度饮水可能增加肾脏负担”的句子后面,点进去原内容根本对不上。
引用匹配的精度,目前和实时检索的范围强绑定。如果是纯靠模型训练记忆生成的内容,它标注的引用很可能是凑数的,不是真的对应内容来源。
比如上次问”《红楼梦》里林黛玉进贾府时带了几个丫鬟”,模型给的回答后面挂了个某红学论坛的帖子链接,点进去发现帖子根本没提丫鬟数量的事,纯粹是找了个沾点”红楼梦”关键词的链接凑数。
目前行业对引用机制的调整方向

从实操角度看,现在不少做AI搜索的团队,都在给引用机制加”可信度权重”——不是随便找个网页就当来源,会优先匹配官方公开文档、正规学术平台、正规媒体的公开内容,那种随便发的个人博客、营销软文的链接,会被压到引用优先级的较低位置。
有意思的是,现在还有个小趋势,大模型会在引用旁边标出来”该来源和当前内容的匹配度”,如果匹配度达不到阈值,就不会把这个来源当成正式引用展示出来。这种做法目前在一定程度上能减少错配的问题,但还做不到完全精准。
您在实际使用大语言模型找资料的时候,还遇到过哪些引用相关的情况?欢迎结合具体场景继续探讨。
