刷到一段带爵士BGM的复古咖啡店短视频,想找同风格的拍摄素材、同BGM的剪辑片段,用普通关键词搜根本凑不齐。这时候就得靠多模态内容检索了。
日常场景里的多模态检索,到底是怎么运作的?
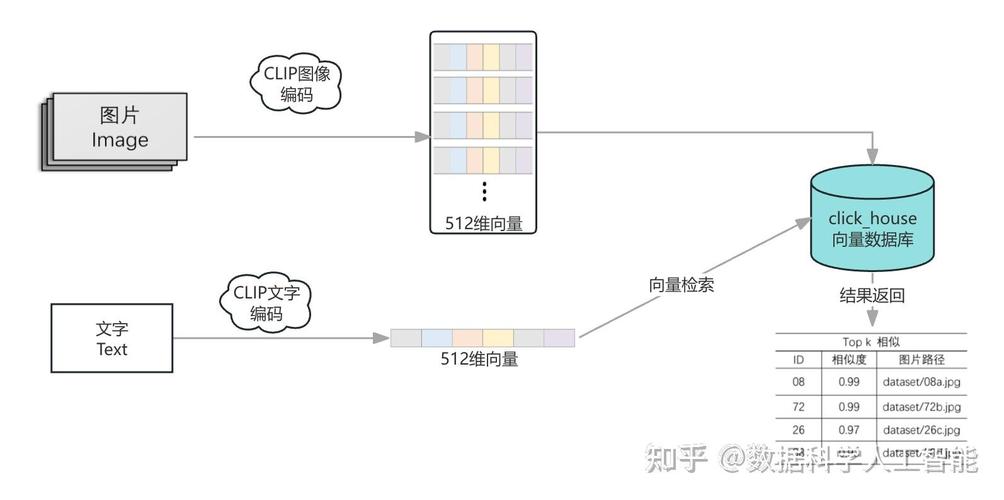
普通检索是靠文字标签匹配内容,多模态检索的核心是把文本、图片、音频、视频都转成同维度的数字特征,再计算不同内容之间的相似度。
举个例子,你拍了一张路边三花猫的照片,想找同款猫咪的短视频、同角度的巷拍素材,甚至同风格的表情包,不用挨个输关键词,直接上传图片就能匹配到跨类型的内容。
据一些做自媒体素材整理的用户反馈,用多模态检索找同风格素材的效率,比逐页翻素材网站高不少。
说实话,之前我以为这是大厂才用的技术,后来才发现普通人找图、找视频的时候天天在碰。
实操时容易踩的几个误区
别不信。很多人第一次用的时候都踩过坑。
比较常见的坑是输入太单一。比如你想找暖金色秋日梧桐街道的视频,只上传一张模糊的街拍图,匹配结果很容易飘到不相关的内容。最好同时附带一句简短的文本提示,双重输入的匹配准确率会高很多。
还要留意工具的覆盖范围。有些检索工具只支持图文匹配,传音频进去根本识别不出来,白折腾半天。
对了,要是找的是带版权的素材,还要确认匹配到的内容是不是在授权范围内,别光看风格对就直接用。
和普通关键词检索的核心差异
普通检索是“你说什么我找什么”。比如你搜“橘猫”,出来的都是自带“橘猫”文字标签的内容,要是有个视频里的胖橘没打标签,根本搜不到。
多模态检索是直接识别内容本身的特征。哪怕没打任何标签,只要画面里有圆滚滚的橘猫,就能被匹配出来。
有意思的是,现在不少内容平台已经把这个功能藏在搜索框的小图标里,不用特意找第三方工具就能用。
您在找素材、找特定内容的时候,还遇到过哪些关键词搜不准的情况?欢迎结合具体场景继续探讨。
