2026-10-21 00:31:08 分类:GEO优化
现在用大模型写方案、查资料的人,多半都踩过它一本正经瞎编的坑。所谓反幻觉技术基础,就是帮大模型降低无依据内容输出概率的底层逻辑集合。
基础认知:不是大模型故意骗人
很多人第一次碰到大模型瞎编内容,会觉得是模型在“故意搞事”。
其实不是。大模型的本质是顺着文本规律接话,碰到训练数据里没有覆盖的内容,它不会直白说“我不知道”,反而会顺着上下文凑出一段看起来通顺、格式规范的话。
举个例子:你想查某款小众户外装备的官方保养要求,大模型张嘴就编了个不存在的厂商400客服电话,连“每3个月更换一次防水涂层”这种细节都顺带着凑了三步,这就是较为常见的幻觉场景。
 大模型编造不存在的政策文件案例截图
有意思的是,这种幻觉往往不带主观恶意,输出的内容语气越笃定、排版越规整,反而越容易让人放松警惕,直接把错话当成可信信息用。
实操要点:常见的几个反幻觉落地手段
说实话,目前行业里没有能完全消除幻觉的技术,所有方案都是在一定条件下降低幻觉出现的概率。
较为常见的落地手段是检索增强生成,也就是大家常说的RAG。简单说就是不让大模型靠训练阶段的记忆瞎凑内容,先把你指定的参考资料、专属知识库内容喂给它,要求它只能基于这些给定的内容作答。
据一些用户反馈,如果把企业内部的产品手册、过往合同条款全部整理到专属知识库,大模型输出内容和官方口径的匹配度会有明显提升。
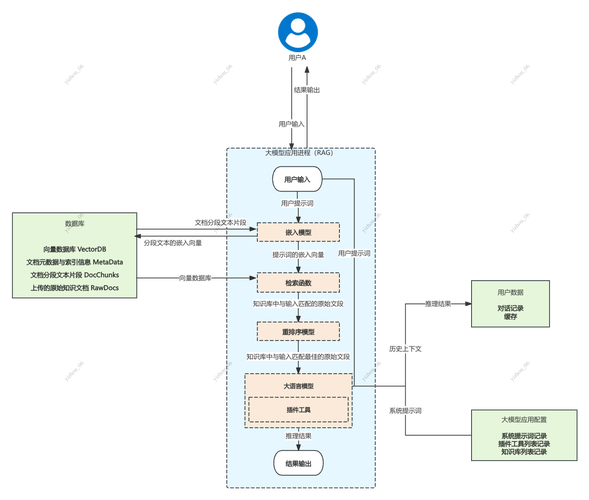 RAG检索增强生成全流程示意图
还有一种常见的手段是给大模型加自我校验环节。比如让它输出完答案之后,反过来逐条核对内容的来源依据,没有对应参考资料支撑的内容,直接标注为“无可靠依据”或者删除。
需要留意的是,这些手段都有适用边界。比如你喂给它的知识库本身就有错误,那反幻觉技术也只会把错误内容说的更顺而已。
容易踩的认知误区
很多人觉得只要开了所谓的反幻觉开关,大模型输出的内容就完全可信。
不对。
有不少人用的时候会跳过“上传参考资料”这步,直接让大模型自由发挥,再成熟的反幻觉机制也兜不住。比如你让大模型写一篇适配你公司的员工手册,却不给它看现有的考勤、报销制度,它哪怕套了反幻觉的壳,也会顺着通用训练数据,把别的公司的规则套到你的场景里。
你平时用大模型的时候,遇到过哪些离谱的无依据输出场景?欢迎结合具体情况聊聊。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:搞懂大模型不瞎编的底层逻辑
文章链接:https://www.ttrenwu.com/geo/3073.html
