现在不管是用大模型写方案、查行业资料,还是对接平台的智能客服,最怕的就是它睁着眼睛说瞎话——这也是反幻觉技术从实验室走到大众日常应用的核心原因。
基础认知:到底什么是反幻觉
说实话,很多人对反幻觉的认知还停留在“让AI别乱说话”的模糊印象里。从实操角度看,它本质是一套给大模型输出“上保险”的校验机制,不是要把模型改得多么聪明,而是给它的回答加几道现实约束。
举个比较常见的例子,你问AI“去年某新一线城市的常住人口是多少”,它可能凭空编出一个带两位小数的精确数字,措辞严谨得像从统计公报里摘的。反幻觉技术的作用,就是在输出前把这个数字和公开的统计年鉴来源做比对,对不上就直接提示“暂未查询到对应公开数据”,而不是硬编答案。
有意思的是,这套机制最早不是给消费级大模型做的。最早的落地场景是金融研报生成、医疗病历辅助这类对错误容忍度较低的领域,后来才慢慢下放到普通用户能用到的智能问答、内容生成工具里。
实操层面的核心落地逻辑
别把反幻觉想得太复杂。目前较为常见的落地路径其实就三类。
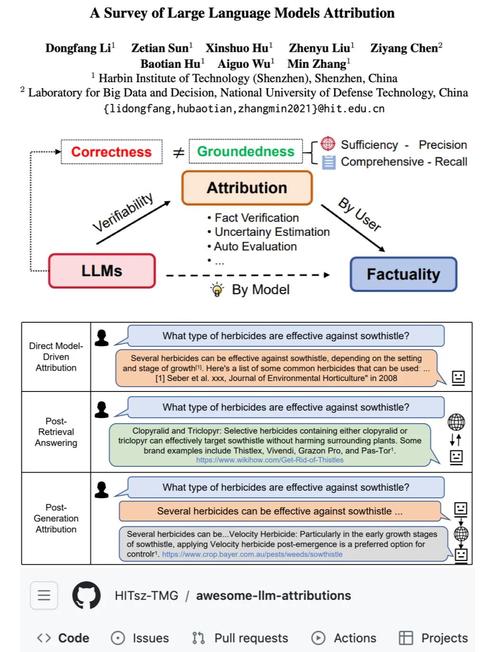
第一类是外部知识库绑定。就是把模型的回答范围圈定在你喂给它的公开资料、企业内部文档里,超出范围的内容直接触发拦截。比如企业内部的智能客服,只会从已经录入的产品手册、售后规则里找答案,不会自己编出一个根本不存在的售后政策。
第二类是实时联网溯源。就是模型生成每一个带事实性的表述时,自动匹配对应的公开网页来源,没有可追溯来源的内容就不放进最终回答里。
第三类是输出后的交叉校验。就是把生成的回答拆成一个个独立的事实点,逐个做真伪比对,把存疑的内容单独标出来给用户看。
需要留意的是,没有哪套机制是能覆盖所有场景的。据一些用户反馈,要是遇到非常细分的冷门领域问题,就算开了反幻觉功能,还是可能出现找不到对应来源、直接输出空答案的情况——这不是技术失效,是对应的公开信息本来就少。
容易踩坑的认知误区
很多人会觉得,开了反幻觉功能,AI说的所有话就都是对的。这个想法挺危险的。
反幻觉技术只能拦截“和公开可查事实冲突”的内容。那些没有明确对错、属于主观判断的内容,比如“这个活动方案会不会帮你提高用户留存”,反幻觉机制是没法做校验的。
还有个常见的坑:别为了追求低幻觉率把模型的输出限制得太死。要是把知识库的范围缩得特别窄,模型就会变得特别木讷,哪怕是很基础的常识性问题,都可能因为不在绑定的资料里直接拒答,反而影响使用体验。
不过话说回来,现在很多免费的大模型工具,反幻觉功能都是默认开启的,很少有用户会特意去调整设置,真遇到答非所问的情况,大部分人也只会觉得是模型能力不行,不会想到是校验逻辑的问题。
您在实际使用大模型工具时,还遇到过哪些看起来特别真实的幻觉输出场景?欢迎结合具体情况继续探讨。
