2026-10-18 22:32:02 分类:GEO优化
很多人用AI搜资料时,总疑惑为啥它给的答案有时候标了来源链接,有时候又凭空编出不存在的文献——这背后就是大语言模型引用机制在起作用。
基础认知:到底什么是大语言模型引用机制
说白了就是模型在生成回答时,把信息来源和生成内容做绑定的一套逻辑。
不是模型天生会找文献。是训练阶段就把公开文本和对应来源标签做了关联,上线后又加了外部检索的接口。
举个例子,比如你问“2024年国内新能源汽车的平均续航数据”,开了引用功能的模型会先去公开的行业报告库里检索匹配内容,再把对应来源的链接附在回答末尾。
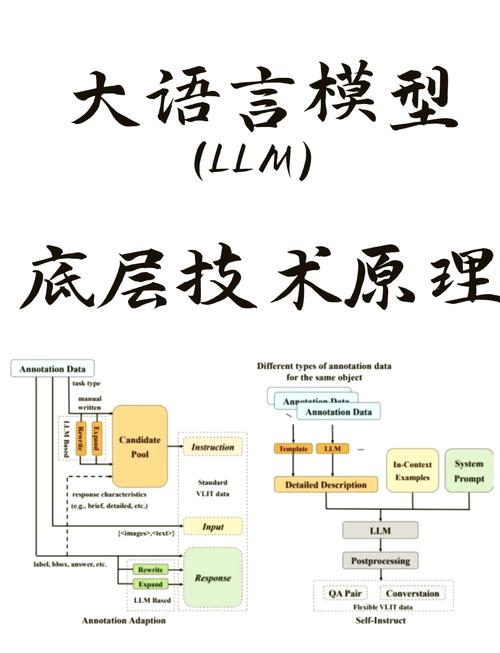 大语言模型引用机制工作流程示意图
有意思的是,这套机制不是所有模型都默认开的。据一些用户反馈,部分免费版模型的引用功能需要手动在设置里开启,默认状态下生成的内容不会附带任何来源标注。
别觉得这是小事。如果关了引用功能,模型生成的内容全是训练数据里的存量信息,碰到时效性强的话题,很容易输出过时的结论。
实操里容易踩的几个误区
很多人以为带了引用的内容就全是对的。
真不是。需要留意的是,模型有时候会把检索到的内容和自己生成的幻觉内容混在一起,哪怕附了来源,也可能出现“来源是讲A的,模型拿过来当B的论据”的错位情况。
另一个常见误区是觉得引用的链接越多越好。通常来说,单条回答里的引用来源如果超过5个,很可能是模型为了凑“看起来严谨”的效果,把相关性不高的内容也硬拉进来了。
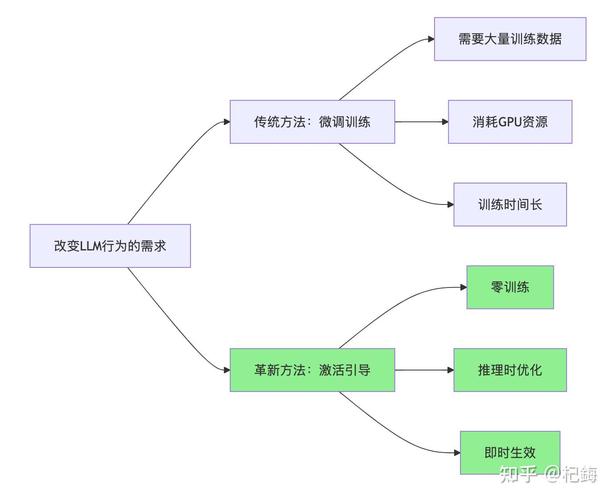 大语言模型引用错位问题示例图
从实操角度看,我们通常可以点开引用链接核对内容和回答的匹配度,尤其是涉及学术、政策类的信息,别直接把带引用的AI答案当权威结论用。
这个操作花不了30秒,但能避开不少引用错位问题。
现在的引用机制还有哪些待完善的地方
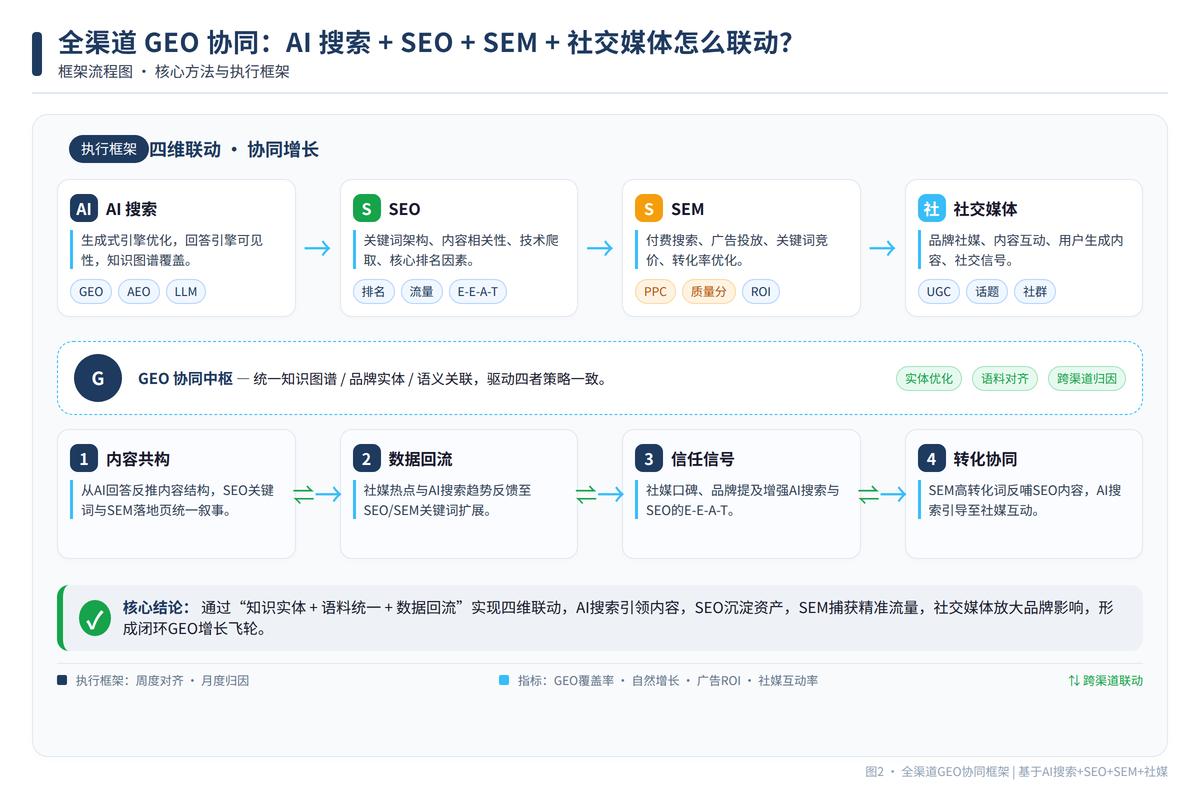 现在的引用机制还有哪些待完善的地方
目前行业普遍观察到的问题,是引用的颗粒度还不够细。比如现在大部分模型的引用只会标整个网页的链接,不会精准对应到网页里的某一段、某一句话的位置。你点进去可能要翻好几屏才能找到模型用到的那段内容,对吧?
还有个容易被忽略的细节,就是部分模型会把自己之前生成的内容当成外部来源引用,看起来标了出处,实际上根本没有外部信息支撑。
这个可能因人而异,有人碰到过好多次,有人用了很久都没发现。
您在实际使用中还遇到过哪些和大语言模型引用相关的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:拆解大语言模型引用机制:从原理到实操的实用参考
文章链接:https://www.ttrenwu.com/geo/2984.html
