2026-10-18 03:20:14 分类:GEO优化
我们平时用搜索引擎搜“某导演2023年拍的悬疑片”能直接出精准结果,背后就有知识图谱与实体识别在起作用。
这俩技术平时都用在哪儿?
实体识别说白了,就是从一段零散的文字里,把有明确边界的具体对象挑出来。
比如你刷公众号看到“去年张译在上海拍的那部刑侦剧拿了奖”,它会自动标出三个核心实体:张译(人物类)、上海(地点类)、刑侦剧(作品类)。
知识图谱的作用,就是把这些零散的实体串成有逻辑的关联网络。
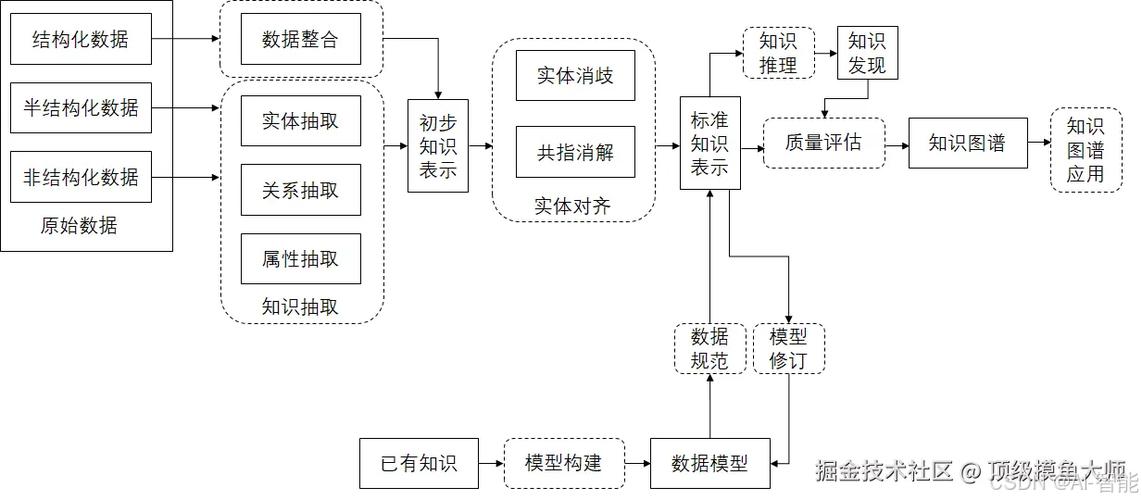 知识图谱实体关联流程示意图
你搜完得到的结果,不会是一堆乱序的新闻链接,而是直接弹出张译的相关作品列表、拍摄地的取景信息、对应奖项的公示内容——全是你要的信息,不用在网页里翻来翻去。
举个电商的例子,你搜“适合油皮的学生党防晒霜”,实体识别会抽取出“油皮(肤质属性)、学生党(人群属性)、防晒霜(品类实体)”,再关联知识图谱里的商品标签,直接给你匹配对应的商品池。
实操里要避开哪些常见误区?
说实话,很多人一开始做项目,上来就选参数最大的通用识别模型,觉得越贵越好。
不对。
如果你是做企业合同审查,要识别“甲方主体、违约金额、交付周期”这类专业实体,就得选适配法律领域微调过的模型。
据一些用户反馈,通用模型对这类专业术语的漏检率能到15%以上,垂直适配的模型能把漏检率压到3%以内。
还有个容易忽略的点:知识图谱不是建完就一劳永逸的。
实体信息是动态变化的——某家公司换了法定代表人,某部剧临时改了上映时间,某个人的职务有调整,通常需要每1-3个月做一次实体信息更新。
 垂直领域实体识别标注示例图
不然错配的关联信息多了,整个图谱的参考价值会直线下降。
真的没必要追求大而全的实体覆盖,先把核心业务相关的实体维护好,比什么都强。
实体识别和普通关键词提取有啥区别?
很多刚接触的人,会把这俩功能搞混。
其实差别挺明显的。
普通关键词提取,可能会把一段文字里所有高频的短语都挑出来,不管有没有实际指向。
但实体识别只认有明确属性边界的具体对象。
比如刚才那句公众号文案里,“拿了奖”是个动作描述,没有明确的实体边界,不会被归为识别对象;但“张译”是有明确身份、作品、关联事件的独立个体,才是核心的识别目标。
有意思的是,不少运营一开始做知识图谱,会把所有带标签的关键词都堆进节点里,最后图谱成了信息垃圾场,找个有效关联都要翻半天。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:知识图谱与实体识别:日常场景与实操避坑指南
文章链接:https://www.ttrenwu.com/geo/2948.html
