2026-10-17 04:46:16 分类:GEO优化
日常刷新闻、查企业资质、搜商品时,系统能快速把零散的文字串成可查的关联网络,靠的就是知识图谱与实体识别的组合能力。
日常场景里的基础应用逻辑
很多人觉得这俩是离日常很远的技术概念,其实早就在你每次搜东西的时候帮你筛信息了。
比如在电商平台搜“适合油痘肌的温和洁面”,系统不会只把带这几个字的商品堆出来。它会先通过实体识别,定位到“油痘肌”“温和洁面”这些核心信息块,再通过知识图谱关联到对应的成分、适用肤质、过往用户的反馈标签,不会把含强皂基的产品硬推给你。
 电商搜索场景实体识别流程示意图
再比如企业做日常舆情监测时,要从每天几万条社交发言里揪出和自身相关的提及,实体识别先把“品牌名”“旗下产品”“关联核心人物”这些实体标出来,知识图谱再把这些实体和对应的事件、情绪倾向串起来,不用人工逐页翻找。
实操里容易踩的认知误区
真的别小看基础环节的问题。
很多人觉得实体识别就是“把关键词标出来”,其实实体识别的核心不是找词,是消歧。
举个例子,同样是“苹果”,在科技数码的讨论里是消费电子品牌,在生鲜板块是常见水果,没有做好消歧规则的话,知识图谱会把完全不相关的信息硬连在一起,最后输出的结果完全没法用。
据一些用户反馈,很多初期搭建知识图谱的团队,上来就堆几百万条实体,却没做基础的实体消歧规则,最后图谱里全是重复、错位的关联,查一个实体能跳出十多个毫不相干的结果,维护成本高到没法推进。
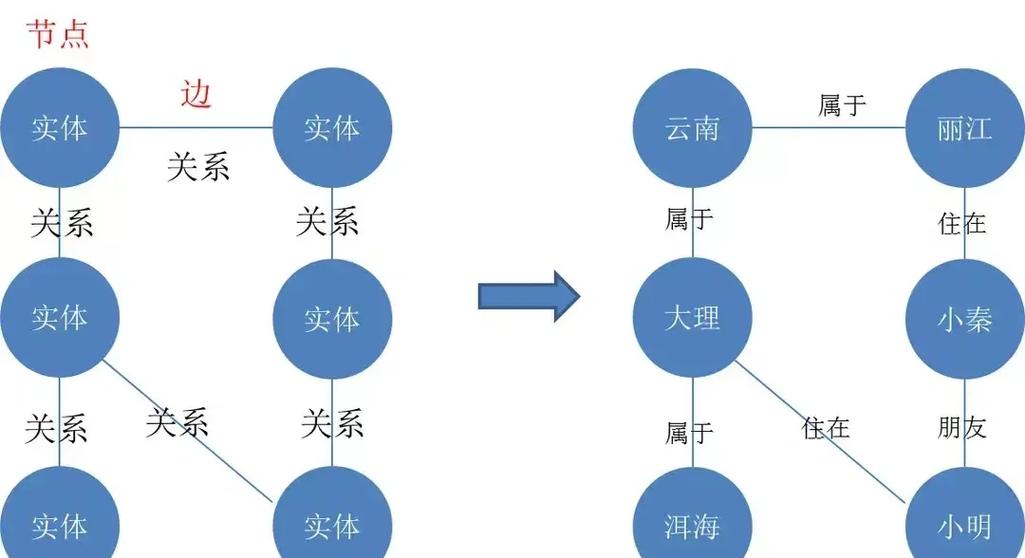 知识图谱实体消歧规则对比示意图
落地时的常见调整思路
从实操角度看,没人一开始就需要覆盖全领域的超大图谱。通常先聚焦1-2个具体的业务场景,比如先做企业内部的供应链关联图谱,只识别供应商、原材料、合作合同这些核心实体,跑通流程之后再慢慢扩充。
需要留意的是,实体识别的规则不是一劳永逸的。每年都会有新的网络热词、新的公司名、新的产品名出现,通常每1-2个月要补一次实体词库,不然碰到新出现的实体就识别不出来。
有意思的是,很多团队会把用户日常查询里的高频未识别词收集起来,补进词库,比纯靠技术团队闭门做的识别准确率高不少。
您在实际搭建或使用这类系统的过程中,还遇到过哪些意料之外的问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:知识图谱与实体识别:把零散文本转成可用信息的落地思路
文章链接:https://www.ttrenwu.com/geo/2907.html
