2026-10-15 11:36:37 分类:GEO优化
你有没有遇过大模型给你编了个根本不存在的论文作者,还煞有介事说人家2023年发在顶会?这种就是典型的大模型幻觉,而反幻觉技术基础,就是帮你把这些瞎编的内容摁回事实边界的整套入门方法。
先搞懂:反幻觉到底是在拦什么
很多人以为反幻觉是要让大模型全知全能。
根本不是。
它的核心是给模型的输出套上事实校验的”围栏”,不让它顺着概率瞎接话。
举个例子,你问它”北京到上海的高铁最快多久”,它不会瞎编个4小时出来,而是会去匹配已有的公开车次数据。
 大模型幻觉产生概率路径示意图
说实话,很多人踩坑就是觉得模型输出的字都通顺,就默认内容是对的。
从实操角度看,现在落地较为常见的反幻觉场景,就是企业内部知识库问答——毕竟要是销售给客户发的方案里编了个不存在的产品参数,那麻烦可就大了。
落地较为常用的三个基础手段
不用搞太复杂,入门阶段你只要盯三个方向就行。
第一个是检索增强生成(RAG),说白了就是先让模型去你指定的资料库里找依据,找不到就直说不知道,不许自己瞎编。
第二个是输出校验层,就是在模型生成内容之后,套一个专门的规则检测器,把里面的人名、数据、专有名词挨个和原始资料比对。
第三个是调低采样温度,这个可能很多人不知道——温度越高,模型越爱”发挥”,想要稳一点,把温度调到0.1到0.3之间,瞎编的概率会降不少。
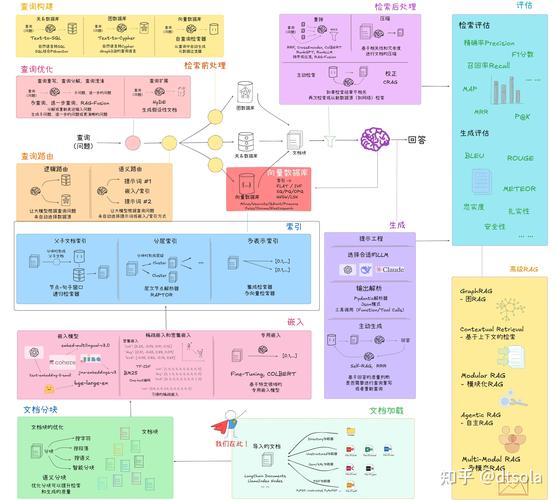 企业知识库RAG反幻觉流程示意图
据一些用户反馈,刚把RAG的检索召回率从60%提到90%的时候,输出里的无依据内容能少掉七成多。
新手很容易踩的认知误区
别信什么”上了反幻觉就完全没幻觉”的忽悠。
这个可能因人而异,不同场景的容错度本来就不一样。
比如你让模型写个朋友圈文案,就算它编了个不存在的小众景点,顶多被朋友吐槽两句。但要是做医疗问答、法律条文解释的场景,哪怕有小比例的错漏,都可能出问题。
需要留意的是,反幻觉技术不是一劳永逸的——你的知识库三个月不更新,里面的产品参数早就变了,模型就算严格按资料输出,出来的内容也是错的。
还有人觉得只要把模型调得够”听话”就不会瞎编,实际上模型本质是在算下一个字的概率,没有人类那种”我真的知道不知道”的元认知能力,光靠prompt约束的效果,通常远不如套上实际的事实校验层靠谱。
你在实际用大模型的过程中,还遇到过哪些离谱的幻觉场景?欢迎结合具体情况一起探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:让大模型输出更靠谱的入门逻辑
文章链接:https://www.ttrenwu.com/geo/2841.html
