平时接触到的实体识别,藏在哪些日常场景里
别觉得这是离你很远的技术。举个常见的例子,你在外卖APP搜“附近能做免辣的川菜馆”,系统要先从这句话里拆出三类实体:代表位置的“附近”、代表属性要求的“免辣”、代表品类的“川菜馆”,才能匹配到后台对应的商户信息。
上次我搜“猫得猫瘟要花多少钱”,系统直接把“猫瘟”识别成宠物医疗领域的实体,没给我跳去人用传染病的科普页面。这步要是错了,整个搜索体验直接垮掉。
搭知识图谱比较容易踩的几个实操坑
别贪多。很多团队一开始做知识图谱,就想把所有能摸到的信息都塞进节点里,结果越做越乱。比如做本地餐饮的知识库,没必要一开始就把每道菜的进货渠道都标成独立实体,先把“品牌-门店-菜品-用户评价标签”这层核心关系跑通,再慢慢扩展外延内容就行。
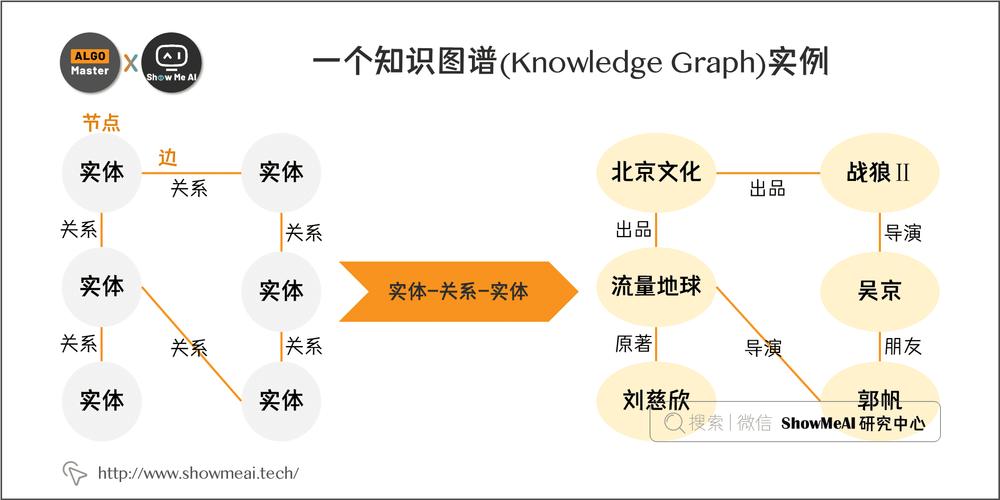
据一些用户反馈,前期贪多求全搭出来的图谱,最后连检索准确率都达不到60%,后期光梳理冗余节点就要花掉3倍的搭建时间。
需要留意的是,实体消歧的权重别放太低。比如同样是“苹果”,在水果品类图谱里是生鲜食材,在消费电子品类图谱里是数码品牌,要是消歧逻辑没做细,很容易把两个完全不相关的实体混到一块,最后搜出来的结果驴唇不对马嘴。
这东西也不是搭完就一劳永逸。通常每季度要过一遍新增的实体信息,比如新上线的门店地址、新推出的网红菜品,不然过俩月图谱里的信息全是过时内容。
和普通关键词检索到底差在哪
现在靠实体识别把“鲁迅”“周树人”都标记成同一个人物实体,在知识图谱里直接挂上“同一人物”的关联关系,不管你搜哪个名字,都能直接拿到关联的所有结构化信息,不用翻半天网页拼凑零散内容。
有意思的是,很多人觉得这是什么高深的前沿技术,说白了就是把以前人整理资料时做的人物关系卡、词条索引,换成机器能读懂的结构化格式。
您在实际使用这类工具时还遇到过哪些识别错配的情况?欢迎结合具体场景继续探讨。
