现在不管是用大模型写方案、查资料,最怕的就是它对着不存在的文献、编错的参数侃侃而谈——反幻觉技术就是给这类输出踩刹车的核心工具。
先搞懂:幻觉到底是怎么冒出来的?
从实操角度看,大模型的幻觉本质上不是它“故意撒谎”,是训练阶段学的是语言的统计关联,不是事实的因果逻辑。
举个例子,上个月同事用大模型查国内某新能源车企的专利数量,结果它编了三个根本不存在的专利申请号,连专利局的公开检索系统都查不到。
说实话,刚接触大模型那会我也踩过这坑,把它编的参考文献直接粘到论文初稿里,被导师打回来的时候脸都发烫!
它知道“车企+专利”这俩词经常凑一块出现,就顺着语感往外拼,根本没核对过事实。没有外部信息锚定的时候,只要句子读着顺,它就敢往下写。
日常能用的反幻觉基础操作
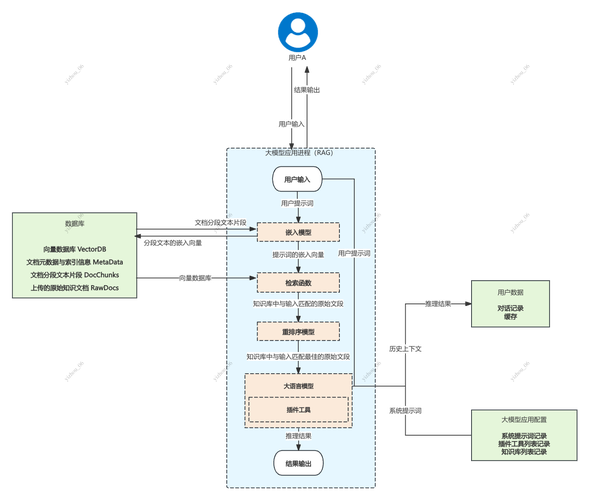
现在大家接触较多的反幻觉手段,就是检索增强生成(RAG)。
举个例子,你让大模型写公司的报销制度,别直接让它凭记忆写,把公司最新的报销文件、过往的报销审批记录都喂给它,让它只能在你给的材料里找答案,它瞎编的概率就会低很多。
有人觉得给大模型加个“你不能瞎说”的提示词就能解决问题?
没用的。
据一些用户反馈,只加提示词的约束,对涉及具体数字、专有名词的问题,纠错效果通常不到两成。需要留意的是,喂给它的参考材料本身如果有错误,它一样会照着错的来——之前有个用户把自己存的过时的行业报告上传到RAG系统,结果大模型出来的所有数据全是三年前的老数,反而比之前更难发现问题。
别神化:反幻觉技术的边界在哪
很多人觉得上了反幻觉系统就能让大模型完全说真话?
不对的。
比如你问它“明天某只股票会不会涨”,就算接了实时的行情检索,它也没法给出确定的答案——因为这类问题本身就没有固定的事实依据,反幻觉技术能做的,只是让它不编出来根本不存在的政策、财报数据,没法替你预判未来。
有意思的是,现在不少做企业服务的团队,把反幻觉的效果吹得太满,最后客户用的时候发现还是会错,反而对大模型更不信任了。从行业普遍观察来看,现在的反幻觉技术,更适合用在有明确公开事实依据的场景——比如政策解读、内部制度查询、学术资料整理这类,要是用来做创意类的内容,比如写小说、编段子,其实反幻觉的约束反而会限制效果。
您在实际使用大模型的过程中,还遇到过哪些让人哭笑不得的幻觉场景?欢迎结合具体情况一起聊。
