基础认知:两者的协作关系
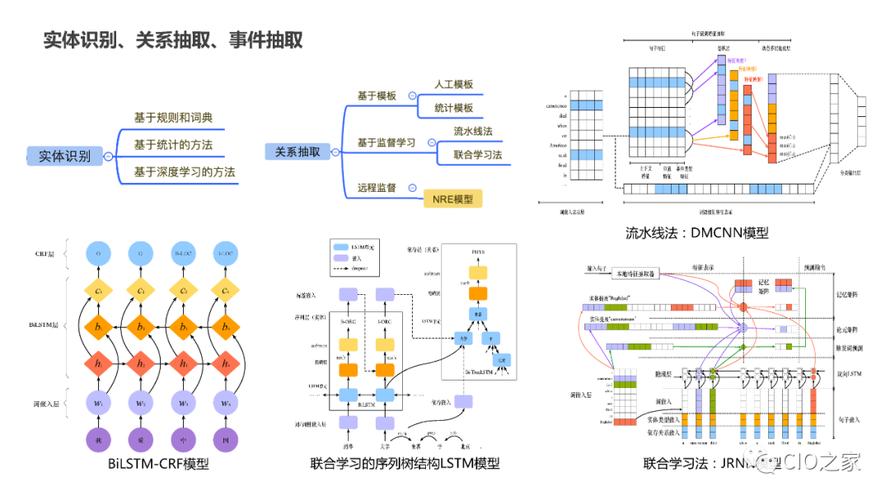
实体识别是知识图谱构建的第一步,简单说,实体识别负责从一堆文字里把有意义的独立个体抠出来,知识图谱负责把这些实体的关系连起来。
举个生活化的例子,你在电商平台搜“华为Mate60手机壳”,实体识别会先拆分出“华为Mate60”“手机壳”两个核心实体,再把实体信息给到知识图谱,匹配出对应关联的商品,不会把华为其他型号的手机壳推给你。
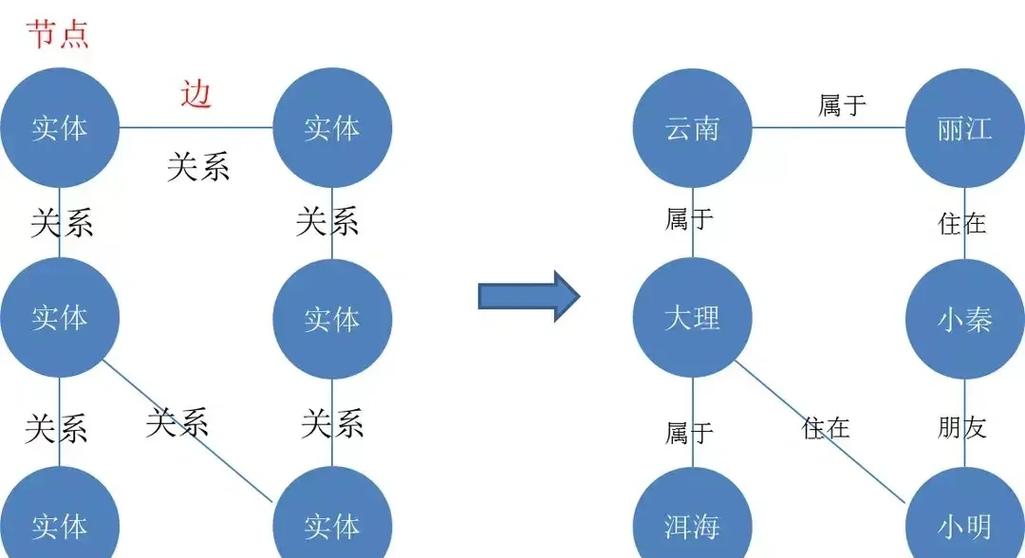
换个场景,你搜“周杰伦晴天歌词”,实体识别抠出“周杰伦”“晴天”两个实体,知识图谱直接调出两者的所属关系,给你想要的结果。
实操里要留意的常见误区
不少刚接触的人会觉得,实体识别不就是抠关键词吗?其实差远了。
最常见的问题是实体歧义,同样两个字,意思可能完全不一样。比如“小米”,可以是谷物,也可以是手机品牌,要是实体识别分错,知识图谱再怎么搭都是错的。
据一些用户反馈,做垂直领域内部知识库的时候,一开始直接用通用预训练模型,没做本地化调整,结果有近三成的实体识别错误,后期整理起来花了一倍的时间。
从实操角度看,针对细分领域,通常需要给模型喂几百条行业标注数据做微调,能大幅降低错误率。
普通人也能用的落地场景
不是只有AI算法工程师才碰这东西,普通运营、行政甚至小老板都能用得上。
比如做内容运营的,整理半年的用户评论,用实体识别自动把用户提到的产品功能、好评差评点抠出来,导入自己的小型知识图谱,找用户反馈的时候直接搜关键词就能出来,不用翻几百页表格。
这个可能因人而异,要是你面对的文本本身很不规范,比如大量手写转写的口语化内容,准确率确实会打折扣,这个要提前有预期。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
