2026-10-05 05:02:46 分类:GEO优化
现在用大语言模型查资料、写正式文稿,最让人头疼的就是不知道AI说的话来自哪里,大语言模型引用机制就是用来解决这个痛点的。
基础认知:它到底是什么,通常用在哪儿
简单说,它是大语言模型生成内容时,同步标注信息来源的一套逻辑。
和AI随便给你甩几个无关链接不一样,正经的引用机制会把生成内容用到的原文片段、来源出处、发布信息一一对应上。
比如你用带引用机制的AI整理行业政策,它会把每一条规则对应到具体的官方发文文号、发布页面。
再比如你写课程论文,它会帮你把用到的核心观点对应到对应的核心期刊文献,不用你再去翻数据库翻半天。
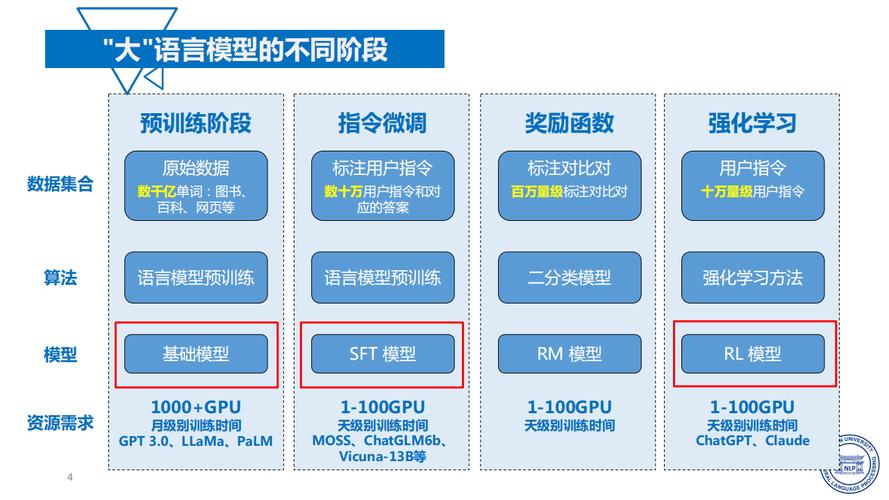 大语言模型引用机制输出效果对比图
实用注意事项:避开这些常见坑
说实话,很多人对引用机制有误解,觉得有了引用就万无一失,这其实是错的。
据一些用户反馈,不少带引用机制的模型也会出现来源错配的问题——比如把A作者的观点标成B作者的,把去年的行业报告标成今年的。
需要留意的是,哪怕AI标注了引用,你也要核对来源的准确性,尤其是涉及到数据、法规这类要求精准的内容。
另外,不要直接把AI标注的引用直接插进自己的正式文稿里,不同出版、发表场景对引用格式有不同要求,AI自动生成的格式通常需要调整。
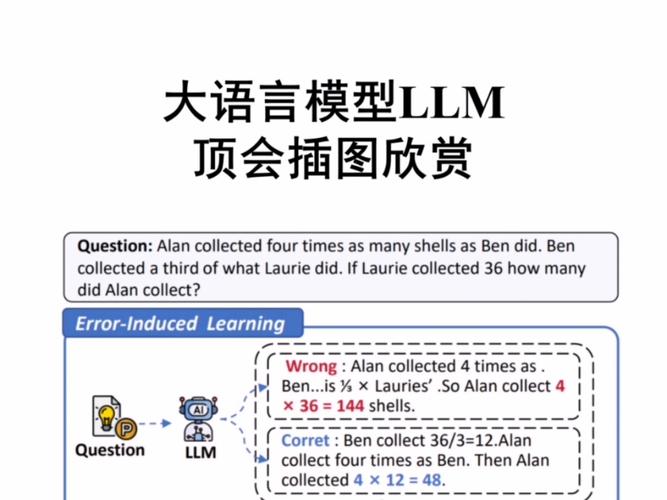 大语言模型引用错配常见案例示例
延伸:它和普通AI补引用有什么不一样
 延伸:它和普通AI补引用有什么不一样
有意思的是,很多人分不清“AI事后补引用”和“正经引用机制”的区别。
普通大语言模型生成内容,是先生成内容,再反过来找看起来匹配的来源凑数,很容易张冠李戴。
正经的大语言模型引用机制,是先检索合规数据库找到符合要求的可信来源,再基于来源内容生成回答,最后同步标注出处,逻辑顺序反过来,出错率低很多。
从实操角度看,这类带成熟引用机制的模型更适合学术写作、行业研报、公开科普内容创作这类对信息溯源要求高的场景。
您在实际使用大语言模型的过程中,还遇到过哪些和引用相关的问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:大语言模型引用机制:底层逻辑与实用使用注意事项
文章链接:https://www.ttrenwu.com/geo/2352.html
