2026-10-04 16:16:10 分类:GEO优化
反幻觉技术是当前生成式AI产品中,用来修正输出内容不实问题的常用技术,几乎所有面向商用的AI工具都做了基础适配。
反幻觉技术的基础认知与使用场景
说白了,反幻觉就是帮AI把“一本正经胡说八道”的概率降下来。
大模型天生会根据概率生成文字,碰到自己不熟悉的内容,很容易顺着上下文编出不存在的事实。
比如你问AI某高校最新的研究生招生简章招生人数,它可能瞎编一个数字凑出来,很多用户都碰到过这种糟心事。
放到企业场景里,比如用AI整理公开的行业政策文件,错误的信息会直接影响决策,反幻觉技术就是用来解决这类问题的。
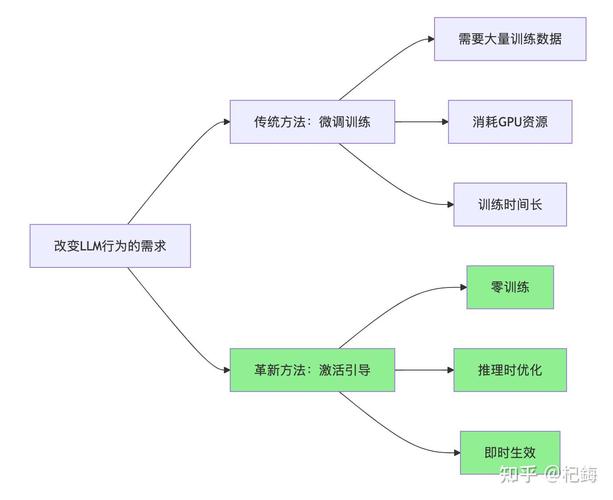 大语言模型反幻觉技术处理流程图
反幻觉技术的两大基础实现路径
目前行业里较为常见的基础实现路径,分为 前置约束 和 后置校验 两类。
前置约束是从源头限制,提前给模型喂入经过整理的可信知识库,要求模型只能从给定内容里提取信息输出。很多企业搭内部AI问答机器人,用的就是这个思路。
后置校验是先生成再把关,模型先输出内容,再由专门的校验模块匹配可信数据源,把错误内容揪出来修正。
说实话,两种路径各有优劣,适配不同场景。据一些用户反馈,小范围垂直场景里,前置约束的效果更稳定。
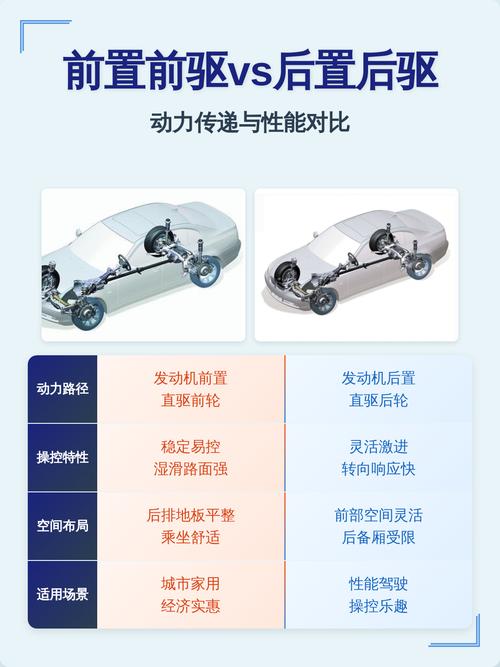 反幻觉技术前置后置路径对比示意图
落地基础反幻觉方案的常见误区
 落地基础反幻觉方案的常见误区
很多新手刚配置的时候,容易觉得反幻觉约束越严格越好。其实不对。
过度严格的约束会让模型输出变得非常死板,连正常的语义连贯都做不到,更别说生成有创造性的内容了。
还有一个常见误区,就是随便找一堆内容就当可信知识库,里面本身就掺杂了错误信息,反幻觉自然起不到作用。
从实操角度看,配置基础反幻觉的时候,先把要用的数据源整理干净,再根据场景调整约束强度就好。做文案创作可以调松一点,输出专业数据就要调紧一些。
您在实际使用AI生成内容的时候,还遇到过哪些AI瞎编的奇葩情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:帮AI改掉“瞎编”毛病的底层逻辑
文章链接:https://www.ttrenwu.com/geo/2326.html
