基础认知:反幻觉到底解决什么问题
大模型说瞎话的情况,行业里叫“幻觉”。比如你问它某本冷门学术专著的出版信息,它能编出不存在的出版社和作者。
反幻觉技术,就是从技术层面给AI的输出套上“事实缰绳”,减少这种无中生有的错误。
比如在AI搜索小众户外徒步路线的开放时间,没做反幻觉处理的模型,可能把早已关闭的旧营地信息当成新的发给你,坑得你白跑一趟。
就是这么回事。
反幻觉技术的主流基础路径
业内较为常见的两种基础落地方式,都是普通人也能听懂的逻辑。
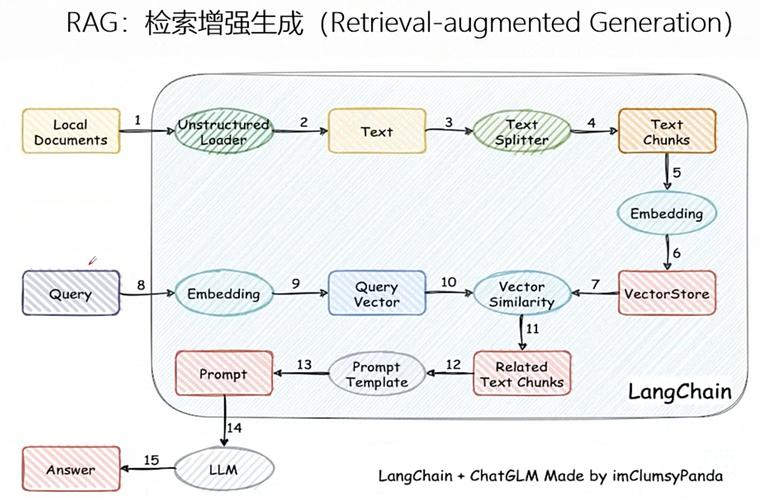
一种是检索增强生成(RAG),简单说就是先让AI去你提前备好的可信知识库搜对应内容,再让AI基于搜到的真实信息组织回答,不让它自由发挥瞎编。
另一种是后验校验法,就是先让AI生成回答,再额外加一层校验模块,把AI说的内容和可信源逐一比对,不对的地方就打回去重改。
说实话,两种方案各有适用场景,没有完美适配所有需求的选项。据一些用户反馈,RAG在垂直领域问答里的效果比较稳定。
入门要避开的常见误区
不少刚接触的人会觉得,反幻觉就是要扼杀AI的创造力。其实完全不是这么回事。反幻觉只是限制AI编造事实,不影响它做创意整合。
还有人觉得,堆进去越多的可信数据,反幻觉效果就越好。需要留意的是,如果输入的知识库本身就有错漏,反幻觉模型也会跟着出错。做好基础数据的清洗,比盲目堆数据重要得多。
从实操角度看,入门阶段先把一种基础路径跑通,再慢慢调整参数,比同时试好几种方案效率高得多。
您在实际接触反幻觉技术的过程中,还遇到过哪些特殊情况?欢迎结合具体场景继续探讨。
