2026-10-01 23:58:19 分类:GEO优化
我们现在用大语言模型查专业信息,越来越依赖带引用的生成结果。
基础认知:它到底解决什么问题
大语言模型引用机制,是给模型生成内容标注信息来源的功能。
通常用在需要溯源的场景,帮用户快速找到原始信息出处。
比如你问某篇公开学术论文的核心结论,开启引用机制的模型,会在给出结论后,标注这篇论文的作者、发表平台和链接。
比如做行业调研整理公开数据,它能帮你省下翻找原始报告的时间。
说实话,这个功能刚出来的时候,不少人都觉得AI终于不会乱编了。
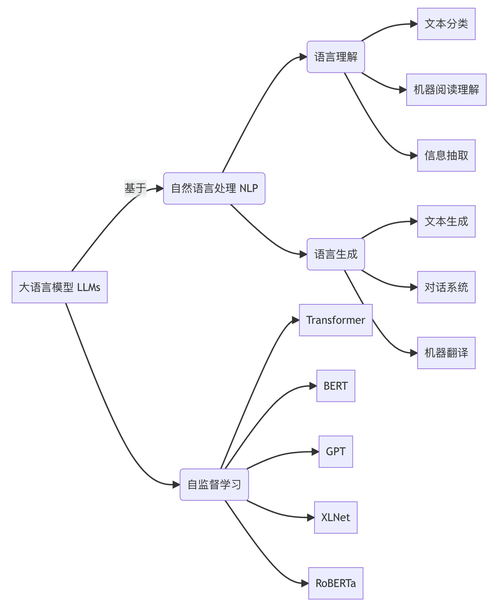 大语言模型引用机制实际输出示例图
日常使用要避开这些常见误区
很多人以为开了引用就万事大吉。真不是。
据一些用户反馈,不少模型的引用匹配逻辑存在误差。
有些模型是先生成内容,再去检索库找和内容沾边的来源挂上,并不是内容真的来自这个引用。
这种“挂羊头卖狗肉”的情况,在不少迭代不完全的模型里较为常见。
需要留意的是,不同模型的引用逻辑差异不小,做检索增强生成时就绑定来源的模型,准确性通常会更高一些。
不过话说回来,哪怕是做的比较好的产品,也会出现匹配错的情况。
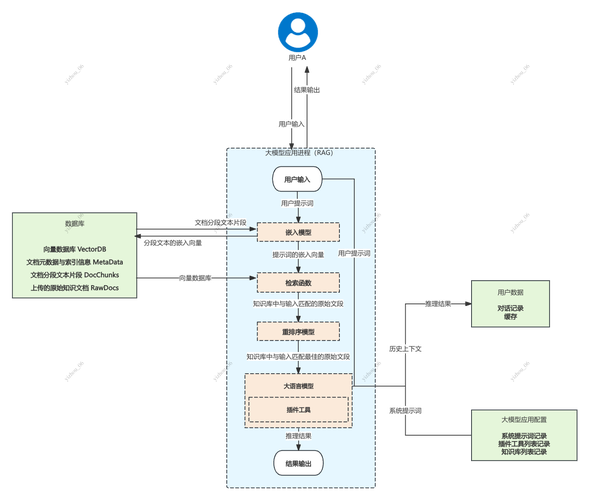 大语言模型RAG引用绑定流程示意图
延伸认知:引用不是“保真金牌”
 延伸认知:引用不是“保真金牌”
很多人会默认,带引用的生成内容就是对的。
说白了,引用机制只是给了你验证的路径,不会帮你把好内容准确关。
从实操角度看,如果你要把内容用在正式场景,比如写报告、发公开内容,一定要点进原来源核对一遍。
这个步骤省不得。
现在行业里还在持续优化引用机制的准确性,未来可能会解决大部分匹配误差的问题,但目前还做不到完全不出错。
您在实际使用大语言模型引用机制的时候,还遇到过哪些特殊情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:拆解大语言模型引用机制:普通人也能懂的实用说明
文章链接:https://www.ttrenwu.com/geo/2196.html
