大语言模型引用机制是什么,通常用在哪儿
它本质是大语言模型生成内容时,自动匹配信息原始来源、标注出处的一套运行规则。
不是随便列几个参考文献就算数。
比如你用带引用功能的AI搜索最新的气候变化研究,生成结论旁边会自动标出哪段内容来自哪篇公开论文,作者、发布时间、来源链接都清晰标记。再比如学生整理文献综述,它可以直接把每个核心论点对应到原文献出处,省了手动翻找的功夫。
使用大语言模型引用机制要留意哪些细节
很多人刚用的时候都踩过坑。
第一个误区就是默认生成的引用一定正确。说实话,模型也会张冠李戴。据一些用户反馈,曾经遇到过模型把甲学者的观点错标成乙学者的核心文献,最后核对的时候才发现问题。
公开可检索来源的引用准确率,通常远高于小众未公开内容,这点要记牢。
另外,模型自动生成的引用格式,不一定符合你的使用要求。不管是学位论文的格式,还是公众号内容的标注规则,都需要自己再调整一遍,别直接拿来用。
它和手动参考文献标注有什么区别
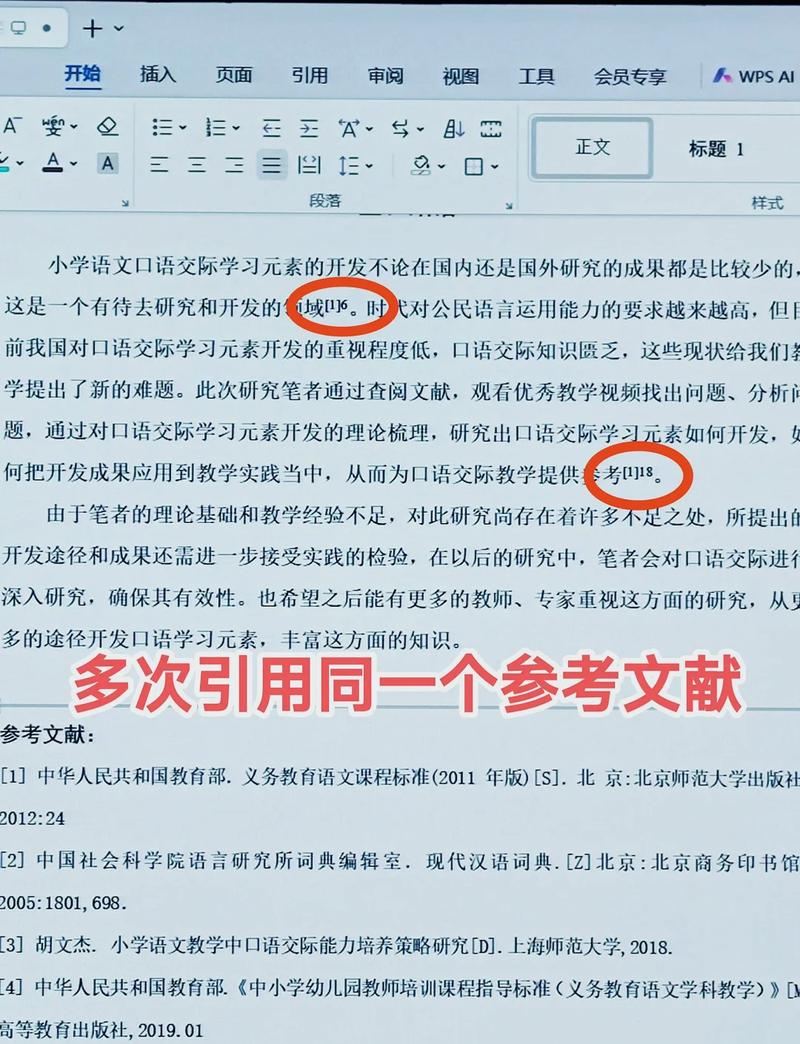
有意思的是,很多人会把这俩搞混。
手动标注是你写完内容之后,再把用到的资料整理好列在末尾,大多只列整体来源,没法逐句对应。而大语言模型引用机制,是在生成内容的过程中同步完成来源匹配,可以做到逐句对应原始出处,效率提升很多。
不过话说回来,当前的引用机制还做不到完全不出错,涉及一些冷门领域的内容,出错概率会高一些。从实操角度看,目前这类功能主要用在AI搜索、学术整理、专业内容创作这些场景,行业还在持续优化精准度。
您在实际使用大语言模型引用机制时,还遇到过哪些特殊情况?欢迎结合具体场景继续探讨。
