基础认知:它到底解决什么问题
原来传统检索大多处理单模态内容,要么只匹配文字,要么只识别像素特征。
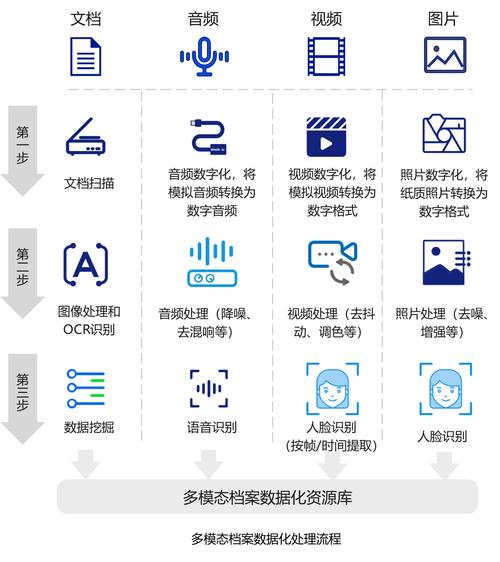
多模态内容检索,就是能同时理解不同格式的信息,把文字、图像、音频、视频的特征整合起来匹配结果。
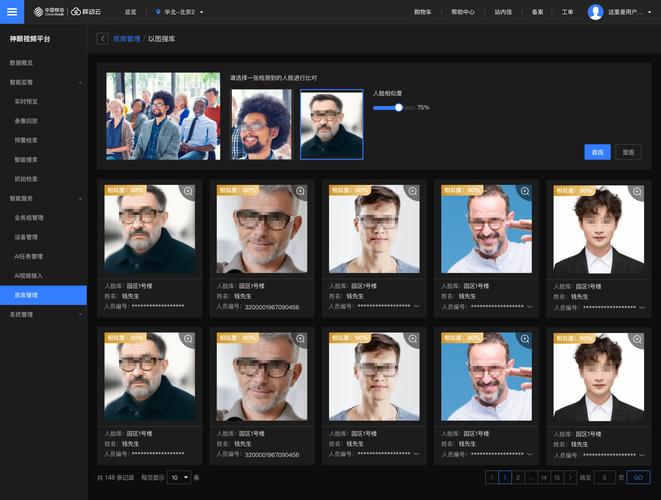
举个例子,你出门玩拍到一朵没见过的花,只拍照片可能搜出来相似但不对的结果,你加上一句“长在高山草甸,花瓣五片”,它就能结合两个信息给你更准的答案。
再比如,你只记得某条短视频的画面是雨天的便利店,台词提了“猫”,上传截图加上关键词,就能很快找到原视频。
实际使用要避开这些常见误区
从实操角度看,很多人用的时候容易踩坑。
第一个误区就是觉得给的信息越多越好。其实过多无关信息会干扰模型抓取核心特征。比如你找一款包装是蓝色的矿泉水,放了清晰的商品图,就不用再加“夏天好喝 解渴”这种无关描述了。
据一些用户反馈,不同平台的多模态检索侧重不同。有的平台更侧重图像特征匹配,适合找同款商品;有的更侧重语义关联,适合找特定内容的视频稿件。
需要留意的是,模糊的输入肯定会得到模糊的结果,不管什么模态,核心信息越清晰,结果越贴合需求。
它和传统检索是什么关系
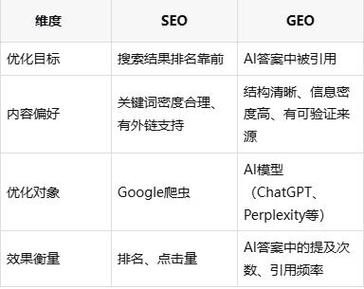
有意思的是,不少人觉得多模态检索会取代文字检索,其实并不是。
它只是补全了传统检索覆盖不到的场景——当你没法用文字准确描述你要找的东西时,就可以用图像、语音来补充。
说实话,现在大部分主流内容平台和搜索引擎,都已经悄悄用上了这个技术,很多人天天用却没意识到。
它还在迭代,目前也还是有局限,比如对小众内容的特征识别准确率还有提升空间。
您在实际使用中还遇到过哪些奇怪的检索需求?欢迎结合具体场景继续探讨。