现在我们用AI生成内容、检索信息,最头疼的就是AI一本正经编瞎话,反幻觉技术就是为了收拾这个烂摊子。
反幻觉技术到底解决什么问题
AI说瞎话的行为,业内就叫「幻觉」。说白了就是大模型本来就是按概率拼字,很容易脱离实际信息,编出不存在的事、错误的数据。
比如你问AI你们公司的报销规则,你上传了员工手册,它却瞎编出差住宿补贴标准,给财务和员工都添乱。这就是典型的幻觉问题。
反幻觉技术的基础目标,就是把AI的输出约束在可信的范围内,降低乱说的概率。
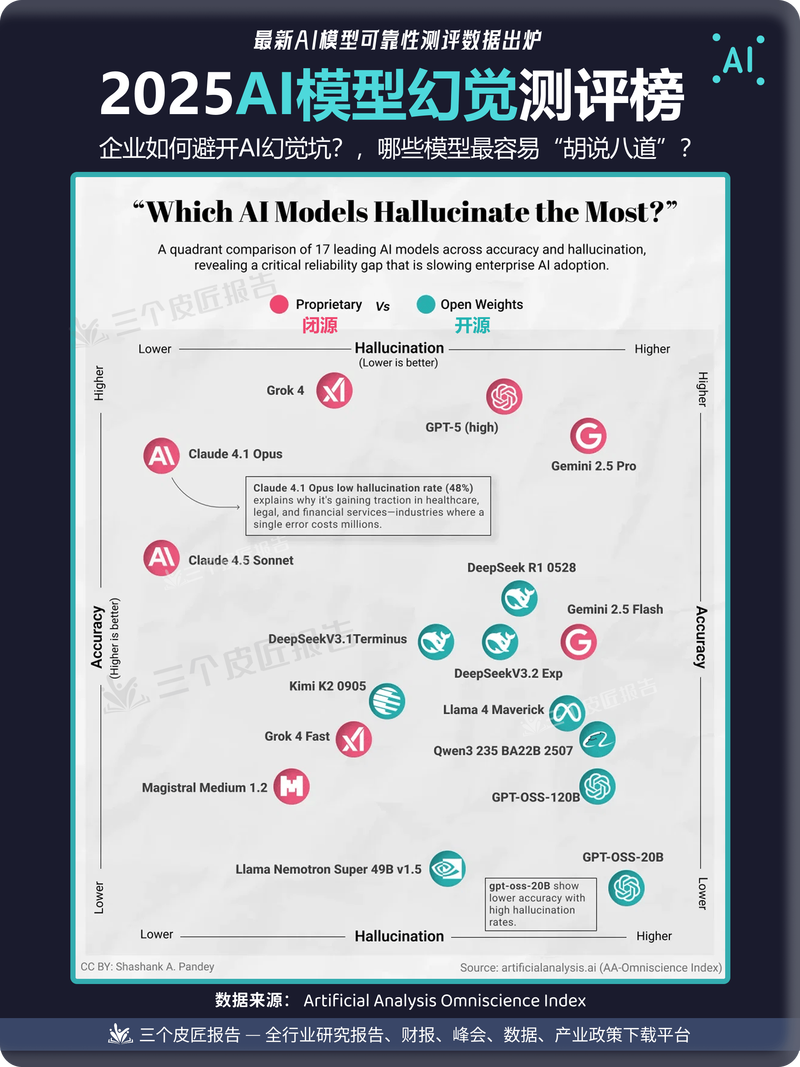
目前主流的反幻觉技术基础路径
行业里较为常见的有两类技术路径,逻辑都很好懂。
第一类是训练阶段调优,就是在训练大模型的时候,专门加入一批标注好的「对错对比样本」,让模型学会区分符合事实的内容,和瞎编的内容。据一些用户反馈,这种方法对通用场景的幻觉降低效果稳定,但训练成本不低。
第二类是推理阶段约束,也是现在很多面向普通人的AI工具常用的方案。最常见的就是RAG框架,简单说就是你让AI回答问题前,先从你给的参考资料里找出和问题匹配的原文片段,再让AI照着原文组织回答,从根上掐掉它自由发挥编瞎话的空间。
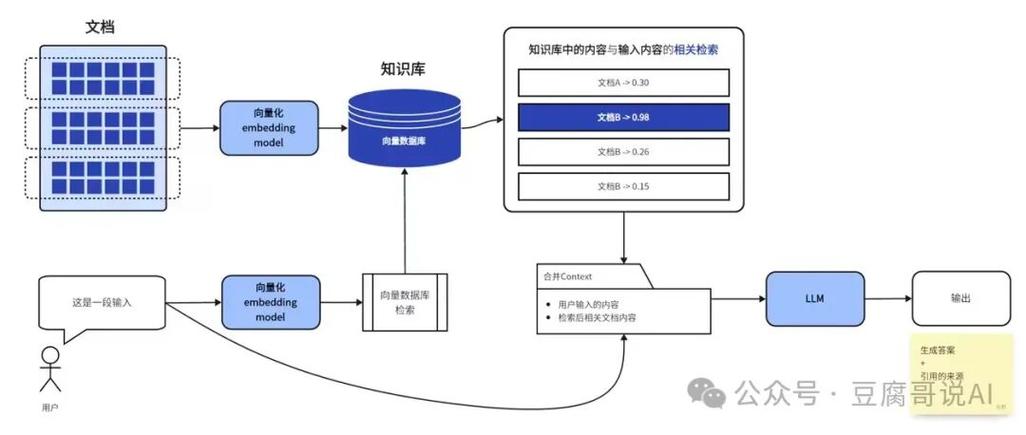
用反幻觉功能要避开的常见误区
说实话,现在没有技术能彻底消灭AI幻觉,不用抱着太高期待。
需要留意的是,如果你用的是RAG类的反幻觉工具,给的参考资料越完整,出错概率越低。比如你让AI整理项目方案,只给了一半的文档,它还是会为了通顺补上不存在的内容,这点一定要注意。
有意思的是,很多人觉得反幻觉约束越严越好,其实也不对。锁得太死,AI只能生硬摘抄原文,连通顺的总结都做不出来,也没法用。松紧度得看具体场景调整。
您在使用AI工具的时候,遇到过哪些离谱的幻觉问题?欢迎结合具体场景继续探讨。
