基础认知:它们到底在解决什么问题
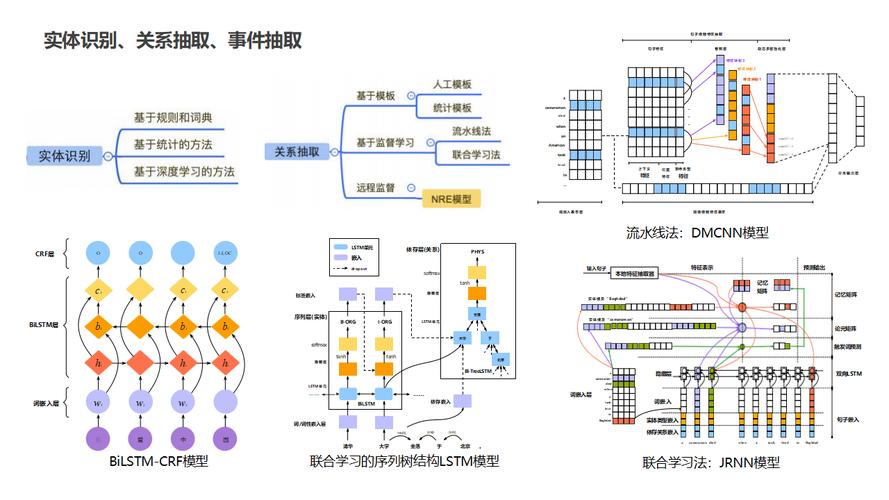
简单说,实体识别的任务,是从一段杂乱的文本里,把有实际意义的独立对象挖出来。比如人名、地名、品牌名、事件名,都是较为常见的实体类型。
挖出来的实体,会交给知识图谱整理。知识图谱就是把所有实体按它们的关系连起来,变成一张能直接查询的关系网。
举个例子,你搜“易烊千玺主演的电影”,实体识别先找出“易烊千玺”“电影”两个核心实体,知识图谱直接调出所有符合条件的结果给你,不用你在网页里自己翻找。
落地应用里容易踩的坑
从实操角度看,很多新手做项目容易犯一个错:搭完知识图谱就不管了,也不优化实体识别模型。
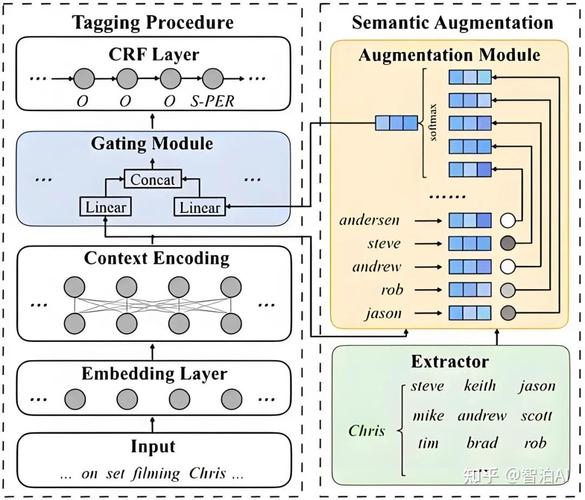
一词多义就是最常见的问题,比如“苹果”可以是水果,也可以是科技品牌,“小米”同理,实体识别如果不做歧义校准,很容易匹配错关系。
据一些用户反馈,不少中小项目的知识图谱用了半年后,准确率会有明显下降,大多是因为没有定期更新新实体。比如新推出的产品、新走红的创作者,都得补进模型的识别库⾥。
搞懂关系:两者不是同一回事
有意思的是,很多科普内容会把两个词放一起说,不少人就以为它们是同一个东西。
其实是上下游的配合关系。实体识别是知识图谱的“原料开采工序”,没有实体识别把实体挖出来,知识图谱就是一张空网。
反过来,知识图谱也能给实体识别提供反馈,帮模型修正识别错误,形成正向循环。现在除了搜索,不少企业做用户数据分析、医疗病例整理,都会用到这套组合技术,能帮人节省大量整理信息的时间。
您在实际接触知识图谱相关项目时,还遇到过哪些实体识别的问题?欢迎结合具体场景继续探讨。
