大语言模型引用机制是什么,通常用在哪些场景
简单说,就是大模型生成内容时,自动匹配并标注信息原始来源的一套运行逻辑。
说实话,大部分普通用户之前都没太在意这个功能,只当是大模型“附赠的小工具”。
比如你要写一篇课程结课论文,让大模型整理近年关于碳中和的研究观点,开启合规引用机制的大模型会给你标清楚文献作者、期刊名称、发表年份,甚至对应章节的大致位置;没做好引用机制的模型,可能直接编出一篇不存在的文献凑数。
使用大语言模型引用机制要留意哪些常见误区
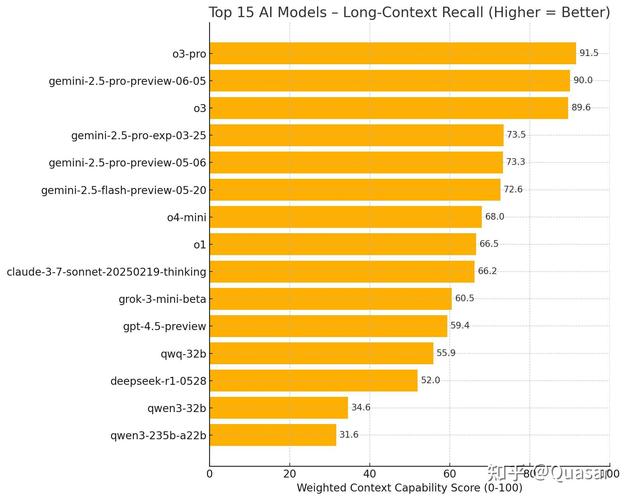
据一些用户反馈,不少人都踩过的坑,就是默认大模型给出的引用全部正确,直接拿来用。
从实操角度看,大模型的引用匹配是基于语义相似度做的,偶尔会出现张冠李戴的情况,尤其是碰到同名作者、同题名文献的时候,出错概率不低。
需要留意的是,如果你的内容要用在正式公开的场景,一定要对所有引用来源逐一核对,大模型只是帮你降低整理的工作量,不会帮你做真实性校验。
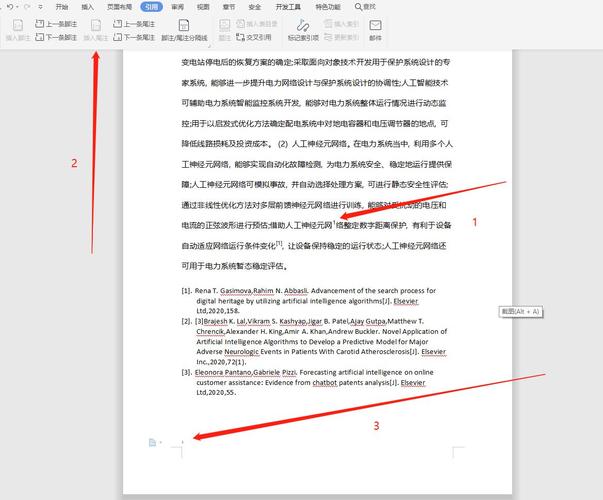
现在不少带联网检索功能的大模型,已经支持引用跳转原链接了,核对起来比以前方便很多。比如你找最新的行业统计数据,引用标注后直接点链接就能跳去原网站核对,省了不少检索时间。
和普通参考文献标注有什么不一样
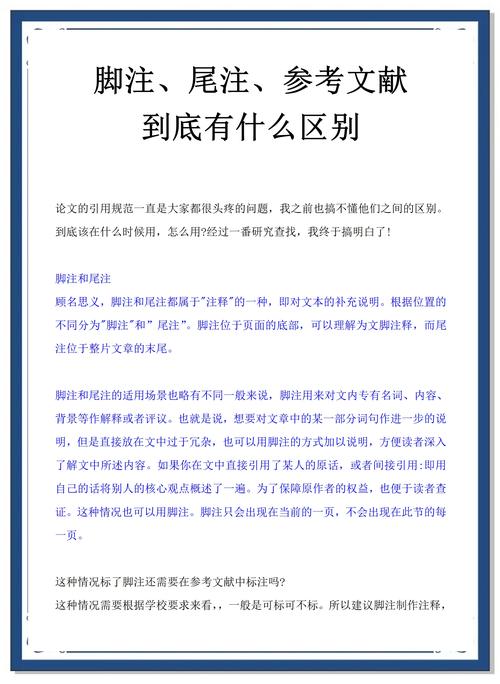
很多人会把两者弄混。普通的参考文献标注,是你写完内容之后,手动整理来源再调整格式,本质是事后加工。
大语言模型引用机制,是在内容生成的过程中就同步匹配来源,边生成边标注,相当于帮你提前搭好引用框架,不用你写完再回头找每一句话的出处。
这个可能因人而异,有的用户习惯自己整理引用,觉得大模型匹配的精度不够,有的用户就喜欢拿大模型的结果做基础修改,提升效率。
根据行业普遍观察,目前多数主流生成式AI工具都在迭代优化引用机制,主要是为了适配更多正式场景的使用需求。
您在实际使用大语言模型生成内容时,还碰到过哪些和引用相关的问题?欢迎结合具体场景继续探讨。