2026-09-23 11:47:43 分类:GEO优化
我们平时让大语言模型生成带文献标注、数据来源的内容,背后靠的就是大语言模型引用机制发挥作用。
大语言模型引用机制到底是什么,通常用在哪儿
说白了,就是大模型生成内容时,给用到的外部信息标注来源的一套运行逻辑。
不是什么遥不可及的黑科技,我们每天都可能用到。
比如你让大模型整理上半年国内露营经济的相关统计,它需要标注数据来自哪个机构的公开报告,这个标注匹配过程,就是引用机制在工作。
再比如科研人员用大模型整理领域综述,需要对应到每篇核心文献的观点出处,也靠这套机制实现。
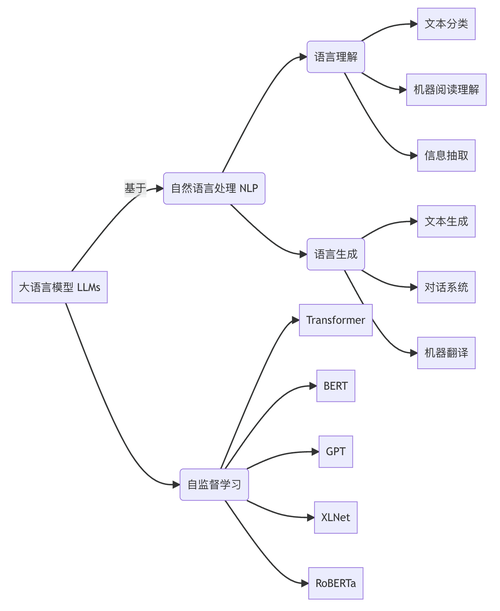 大语言模型引用生成内容演示图
实际使用中需要留意的常见细节
说实话,很多人对这个机制有误解,以为只要生成了引用格式就一定准确。
据一些用户反馈,不少大模型会出现“虚构引用”的情况:格式完全规范,就是找不到对应原文。
较为常见的误区是把大模型生成的引用直接当可信来源用,完全不做核实。
不同大模型的引用逻辑差别不小,有的是先检索到来源再生成对应内容,有的是先生成内容再反向匹配来源,后者出错概率通常更高一些。
比如在你问某篇冷门文献的核心观点时,后一种逻辑就很容易匹配到标题接近、内容完全不对的引用。
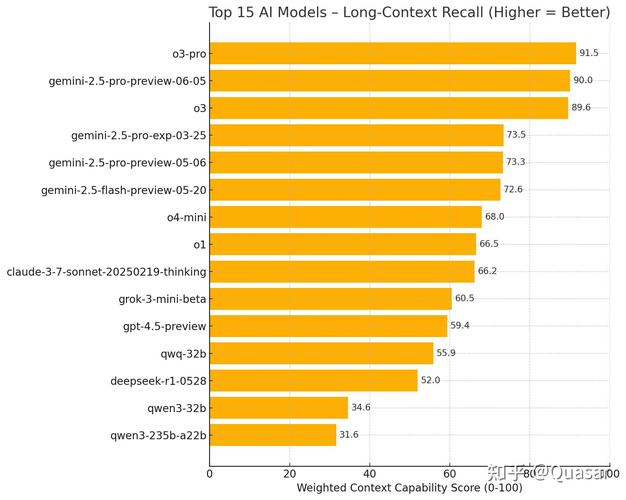 大语言模型错误引用案例对比图
当前行业的常见优化方向
 当前行业的常见优化方向
有意思的是,现在多数大模型都在把引用机制和检索增强生成技术绑定,从数据源头上降低错引概率。
从实操角度看,接入了权威外部知识库的大模型,引用准确率会比纯原生生成的大模型高出不少。
不过话说回来,哪怕技术一直在优化,使用大模型生成的引用内容,还是需要用户自己核对一遍关键信息。
毕竟不同场景对引用准确性的要求不一样,论文发表、项目申报这类场景,核对这一步省不得。
您在实际使用大模型生成引用内容的时候,还遇到过哪些奇怪的问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:拆解大语言模型引用机制:生成内容标注的核心逻辑
文章链接:https://www.ttrenwu.com/geo/1764.html
