2026-09-22 18:12:04 分类:GEO优化
大语言模型引用机制,解决的就是AI生成内容来源可查、避免无授权抄袭的核心问题,现在做学术、写报告、整理行业资料都离不开它。
基础认知:它到底解决了什么实际问题
说白了,就是大语言模型在生成内容的过程中,自动给对应信息标注原始来源的机制。
和早期AI瞎编出处、生成完才补参考文献的玩法完全不同。
比如你写课程小论文,让AI整理近两年AIGC行业的就业数据,开启引用机制后,它会把每个数据对应的原始报告、公开统计页面都标出来,你不用自己翻几十篇文章挨个找。
再比如你整理行业竞品的公开动态,它会直接标注哪段信息来自对手哪场发布会、哪篇官方通稿,省了翻几个小时回放的功夫。
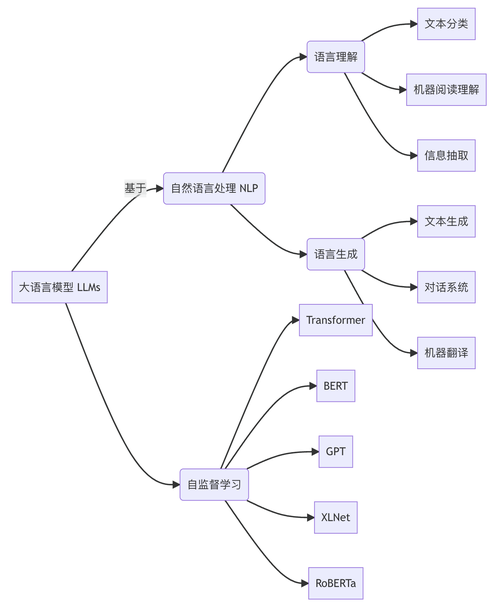 大语言模型引用机制输出示例图
实际使用要留意这些细节
据一些用户反馈,不同产品的引用机制准确率差别不小,有些模型会把关联不大的内容硬套上来源,不能全信。
常见误区要提一下:很多人以为开启引用就可以直接用内容,其实不对,引用只是标注来源,商用或者公开发表,还是要符合原内容的版权授权要求。
从实操角度看,我们通常可以抽1-2个标注的来源交叉核对,就能大概判断这套引用机制靠不靠谱。
不需要每一条都翻,抽几个核心数据或者结论核对就够。
 大语言模型引用来源核对流程图
延伸:和手动参考文献有什么不一样
 延伸:和手动参考文献有什么不一样
有意思的是,不少人会把它和写论文时手动加的参考文献搞混。
手动参考文献一般是全文写完之后,统一加到文末,对应整篇文章的来源。
大语言模型的引用是逐句或者逐段对应来源,直接嵌在内容输出的过程里,拿到就能对应上哪句话来自哪里。
说实话,现在不少学术写作工具已经开始支持直接导入大模型生成的引用格式,确实省了很多整理排版的功夫。
不过话说回来,它目前还是辅助工具,最终的内容核对和版权确认,还是要使用者自己完成。
您在实际使用大语言模型引用功能的时候,还遇到过哪些情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:看懂大语言模型引用机制:普通人也能懂的实用指南
文章链接:https://www.ttrenwu.com/geo/1725.html
