2026-09-22 06:08:52 分类:GEO优化
现在用大模型搜信息、写内容,最闹心的就是遇到一本正经瞎编的情况,反幻觉技术就是用来解决这个痛点的核心技术。
反幻觉技术到底是什么,常用在哪些地方
简单说,它不是某一个单独的算法,是一系列用来降低大模型“胡说八道”概率的技术统称。
大模型的“幻觉”,说白了就是它靠概率拼内容,明明没接触过相关信息,也能编得有模有样。
比如你问某高校某届冷门专业毕业生的具体就业数据,只要这个数据没公开进训练库,它大概率会给你编一套看起来合理的数字。
反幻觉技术目前用得最多的场景,就是专业问答、文献整理、合规内容生成这类对准确性要求高的地方。
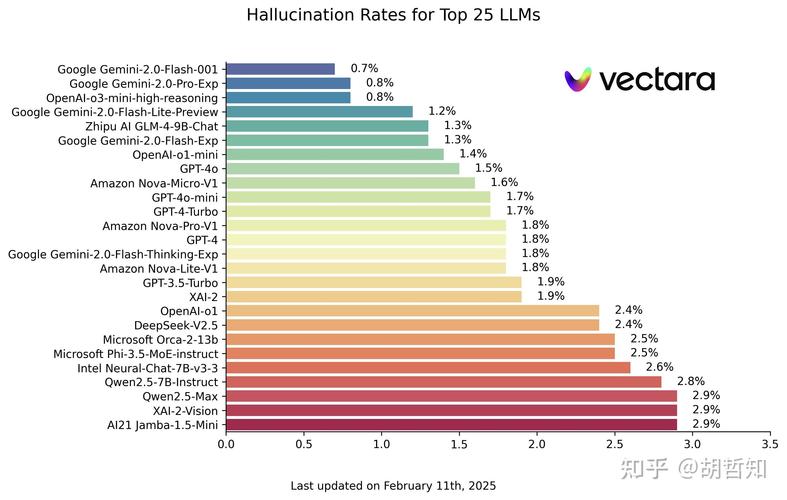 大模型正常输出与幻觉输出对比图
反幻觉技术的两个核心基础
第一个核心是训练阶段的知识校准。
训练大模型的时候,除了喂正常内容,还会特意加很多“我不知道”“超出知识范围”这类样本,同时给已确定的公开知识打上置信度标签,让模型学会区分“确定”和“不确定”的内容。
举个例子,训练法律AI的时候,会特意给模型喂很多没有明确法条支撑的问题,引导它直接说无法解答,而不是瞎编法条。
第二个核心是推理阶段的检索约束。
现在较为常见的方案,是让模型生成内容前,先去提前建好的可靠知识库检索匹配内容,再基于检索到的真实信息生成回答,从源头减少瞎编的空间。
据一些用户反馈,加了检索约束的反幻觉方案,专业领域的错误率能下降不少。
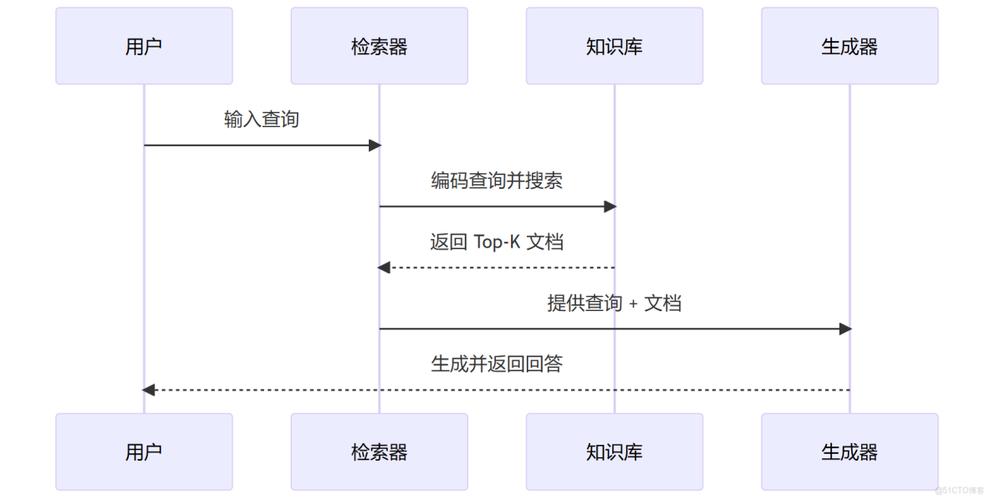 带知识库检索的反幻觉生成流程图
使用反幻觉功能要避开哪些误区
 使用反幻觉功能要避开哪些误区
有意思的是,很多人对反幻觉技术有个误解,觉得它能完全消除幻觉。
其实它只是降低错误出现的概率,做不到彻底根绝。说实话,目前行业里还没有能保证不出错的方案。
还有人觉得反幻觉会扼杀创造力,这个可能因人而异。
大部分商用工具都留了调节空间:做专业报告、查信息的时候把约束调紧,写创意文案的时候可以把约束放宽,适配不同需求。
需要留意的是,哪怕你开了高等级的反幻觉,生成的专业内容,关键信息还是要手动核对一遍。
您在实际使用AI生成内容的时候,还遇到过哪些离谱的幻觉问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:拆解大模型靠谱输出的核心逻辑
文章链接:https://www.ttrenwu.com/geo/1699.html
