基础认知:两个概念怎么配合干活
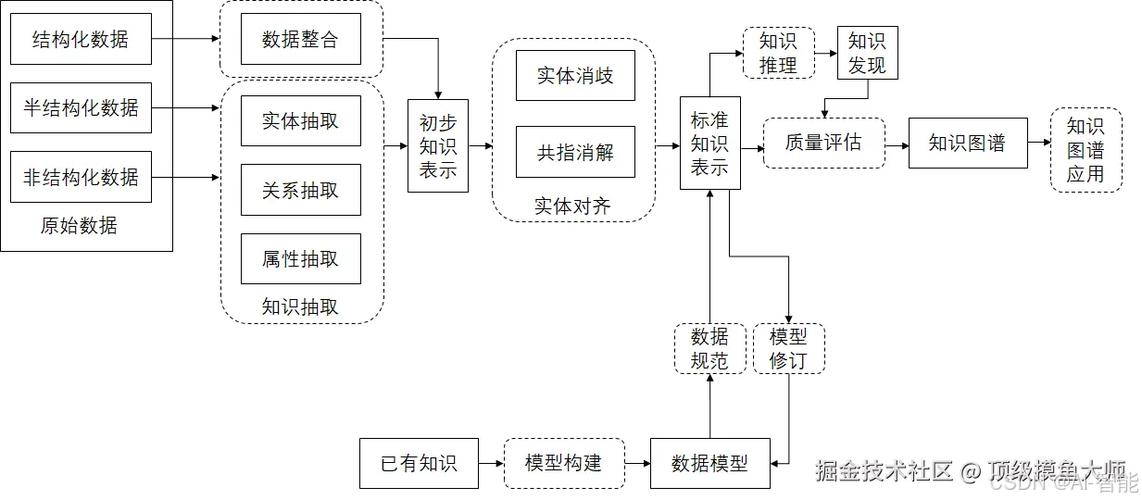
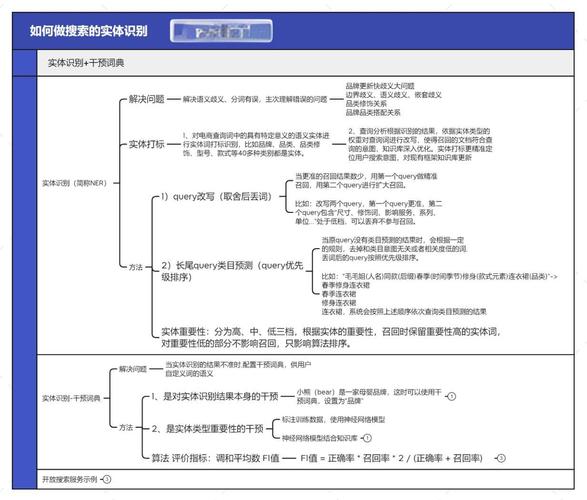
简单说,实体识别是整个流程的眼睛,负责从海量杂乱的文本、音视频内容里,把有具体意义的独立对象抠出来。比如人名、地名、品牌名、事件名,都是较为常见的实体类型。
抠出来之后,就轮到知识图谱登场了,它负责把这些实体之间的关系梳理清楚,织成一张有关系的网。
比如你在搜索引擎输入“周杰伦给五月天写的歌”,实体识别会先拆分出“周杰伦”“五月天”“歌”三个实体,知识图谱再调取两者的合作关系,直接把对应的歌曲名列在你面前,不用你自己翻一堆网页找。
实际落地时容易踩的误区
很多人以为这两个技术只是大厂做搜索才用,其实不是。电商打用户标签、企业整理内部合同、医院整理病历,都能用得上。
说实话,不少刚接触的团队容易踩一个坑:直接拿开源通用模型就用,不对自家领域做适配。
据一些用户反馈,通用模型做金融领域内容处理时,经常把“中国平安”这家公司,识别成“中国”“平安”两个不相关的实体,闹出不少笑话。做医疗领域的话,还可能把药名认错,风险不低。
需要留意的是,不同领域的实体规则差别很大,提前做小批量的领域数据标注,效果会好很多。
延伸聊聊当前的行业变化
有意思的是,现在已经不局限于识别文本实体了,多模态实体识别已经逐步落地,能从图片、监控视频里直接抠出实体,再关联到知识图谱里。
比如你逛公园拍了一棵没见过的树,手机APP能直接识别出树种,还能告诉你这种树的习性、分布区域,就是多模态实体识别加知识图谱的应用。
这个可能因人而异,对不同行业来说,需求差别很大,中小团队不用盲目追多模态的热点,先把文本领域的实体识别做准,够用就好。
您在实际应用中还遇到过哪些实体识别出错的情况?欢迎结合具体场景继续探讨。
