快讯

大语言模型引用机制:AI搜索时代的内容被引用逻辑

你在AI搜索里提问,答案下面那几行小字来源,就是大语言模型引用机制在干活。它不神秘,但常常让人误判——以为被AI提到就等于被引用。哎,差别挺大。
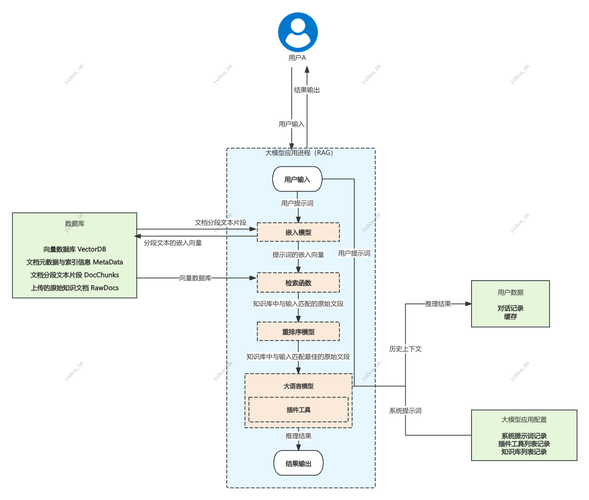
大语言模型RAG检索引用流程示意图
大语言模型RAG检索引用流程示意图

它通常怎么把一段话“挂”到你的内容上

它通常怎么把一段话“挂”到你的内容上
它通常怎么把一段话“挂”到你的内容上
大语言模型生成答案时,引用来源常见有两条路。一条靠参数记忆,模型在训练时“见过”类似内容,回答时像条件反射。另一条靠检索增强,也就是RAG:先把网页、文档、知识库切块,做向量或关键词索引,用户提问后召回片段,再交给模型组织语言。很多AI搜索引擎还会叠加重排、工具调用和事实校验。 比如你问“新能源车险保费为什么有差异”,系统可能抓取一篇长文里的“驾驶评分影响折扣”段落。不是整页被引用,而是那个可独立回答问题的片段被选中。所以,页面开头给结论、小标题写清楚、数据标明出处,通常更友好。说实话,模型没耐心读完整篇散文。 不过话说回来,参数记忆那条路很难追溯。模型可能给出正确信息,却不标注来源。也可能把旧版本数据当新事实。RAG的好处是让模型“看着材料说话”,但材料没被召回,后面再努力也白搭。

想让内容更容易被引用,需要留意这几件事

别只盯关键词密度。AI搜索更在意信息可提取性和来源可信度。下面这些点,从实操角度看更常见。
  • 一个段落讲一个点。 段落太长,切块后容易语义破碎。三到六行比较稳。
  • 标题像问题。 “车险保费受哪些因素影响”比“车险杂谈”更容易命中提问。
  • 给可验证事实。 年份、地区、统计口径、更新日期,能写就写。据一些用户反馈,带时间戳的内容在时效问答里更容易被召回。
  • 别伪造权威。 无来源的“专家表示”反而拉低可信度。
  • 保持HTML可抓取。 纯JS渲染、登录墙、复杂交互,可能让抓取环节就断了。
AI搜索引擎答案引用来源标注界面
AI搜索引擎答案引用来源标注界面
还有个小坑:很多人把schema标记当成万能钥匙。它有用,但只是辅助理解。内容本身答非所问,标记再全也难被引用。另一个误区是堆同义词。RAG召回看语义相似,也看重排质量,重复废话会让片段变得黏糊。

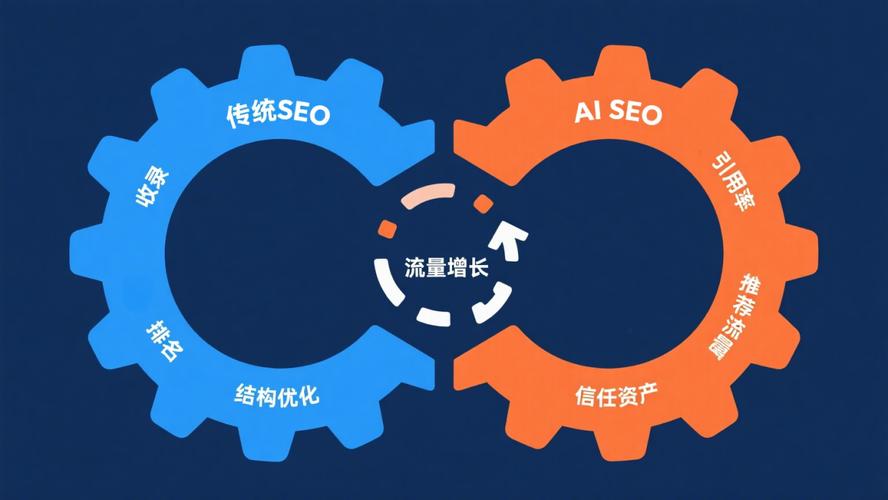
引用机制和传统SEO不是一回事

引用机制和传统SEO不是一回事
引用机制和传统SEO不是一回事
传统SEO争的是排名和点击。大语言模型引用机制争的是是否进入上下文窗口,以及被生成答案时标为来源。被引用不一定带来点击,可能用户看完答案就走了。但它会影响品牌在答案里的存在感。挺有意思,对吧? 从公开信息看,Perplexity、Bing Copilot、Google AI Overview这类产品,展示引用的方式不同。有的给编号,有的给卡片,有的只在特定问题下出现。因此同一篇文章,在一个引擎被引用,在另一个引擎可能毫无动静。这个可能因人而异,也因查询意图而异。 那怎么判断有没有被引用?可以定期用品牌词、产品词、长尾问题去测。看答案里是否出现你的域名、标题或独特表述。注意,模型输出有随机性,同一天不同时间都可能变。别因为一次没出现就懊恼。 未来会怎样?多模态检索、多跳引用、代理式搜索都在推进。内容被切得更碎,引用颗粒度也可能更细。也许以后不是“网页被引用”,而是“某个表格行、某段结论、某张图注”被引用。 您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:大语言模型引用机制:AI搜索时代的内容被引用逻辑
文章链接:https://www.ttrenwu.com/geo/4328.html