现在不管是训练AI模型还是优化网站的搜索展示效果,结构化数据标注都是绕不开的环节——毕竟没有规整的标注,机器根本读不懂人类攒的零散信息。
那些离你很近的标注日常
很多人觉得标注是离自己很远的技术岗工作,其实你每天刷手机的体验,背后都有标注的功劳。
甚至你常用的输入法能准确弹出你想打的网络热词,背后也经过了大量语料的标注校准。
举个常见的,自动驾驶的感知模型训练,要把路牌、行人、路边的共享单车挨个框出来,标清楚每个元素的类别,不然模型可能把穿荧光黄外套的路人当成移动的路障。
 自动驾驶训练集结构化标注工作场景
还有个场景,你在搜“附近的猫咖”时,搜索结果页直接跳出营业时间、人均消费、用户评分的卡片,不是平台瞎猜的,是网站后台做了对应的结构化数据标注,把这些字段挨个匹配成搜索引擎能识别的标签。
实操里容易踩的几个坑
别赶进度。
据一些用户反馈,很多团队做标注的时候只追求速度,同一类实体的标注标准前后差很多——比如今天把“橘猫”归到“宠物”类,明天又把同一张图里的橘猫归到“流浪动物”类,最后训练出来的模型准确率掉得离谱。
需要留意的是,
标注开始前先把统一的规范写在文档里,哪怕是十几条的小规范,也比大家凭感觉标强。日常可以定期抽检10%左右的样本,碰到标注偏差的及时同步给所有参与的人。
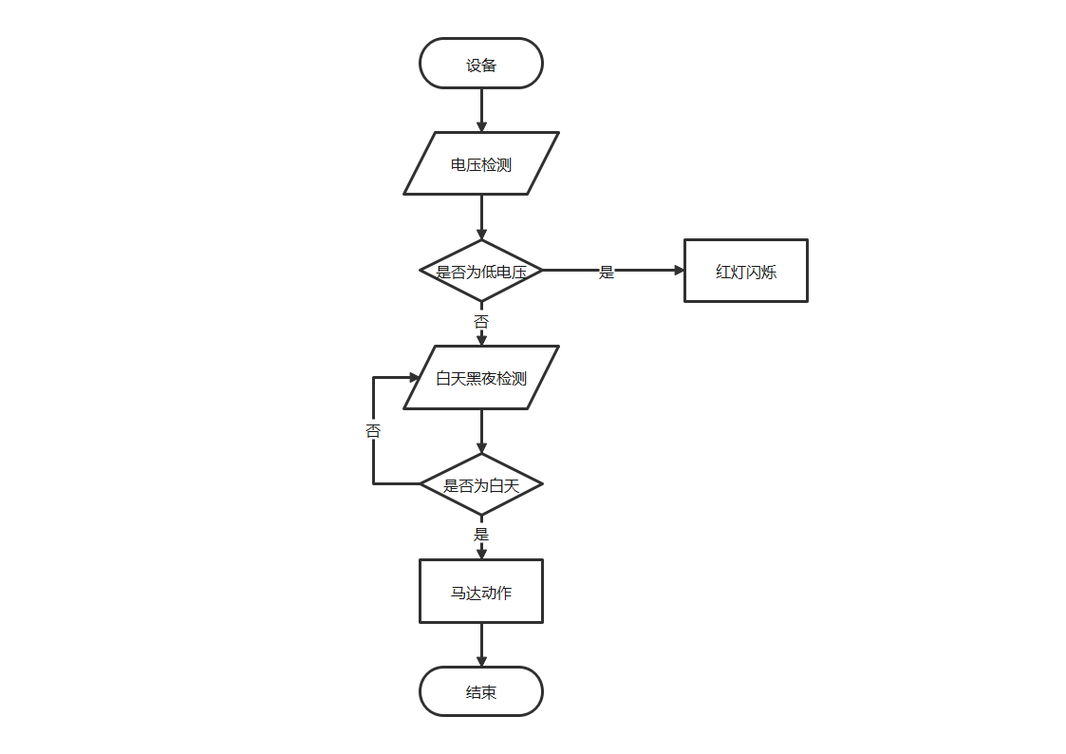 结构化数据标注一致性校验流程示意图
还有个常见的误区,就是觉得标注是纯体力活。其实不是,比如做电商商品的结构化标注,要把“纯棉短袖”“全棉T恤”这种不同表述的商品归到同一个属性池里,没有对业务的理解,标出来的数据根本用不了。
和零散数据整理的核心差异
很多人会把结构化数据标注和平时整理Excel表格混为一谈。
真不是。
你自己整理Excel,只要自己看明白就行。但
标注的核心,是要让没有主观意识的机器能读懂。比如你整理Excel的时候把“发货时效”填成“3天左右”,自己知道啥意思,但机器识别的时候,得把这个表述对应到“预计送达时长”的标准字段,换算成可量化的数值区间,才能被后续的系统调用。
有意思的是,现在不少中小团队开始用半自动化的标注工具,先让模型预标一遍,人只需要修正错漏的部分,比纯人工标效率提升不少,但前提是预标的基础模型得经过初步训练,不然错漏太多,改的时间比纯人工标还长。
您在实际接触结构化数据标注的过程中,还碰到过哪些意料之外的状况?欢迎结合具体场景继续探讨。